Продвижение сайта с помощью ИИ: инструменты и приёмы
Коротко
Как вывести страницы в AI‑выдачу и получить трафик из нейросетей. Разбираем GEO/AEO, техтребования, ботов и разметку, даём готовые сниппеты и чек‑листы. В конце — метрики и шаблон дашборда для контроля цитирований.
Что такое продвижение сайта с помощью ИИ (GEO / AEO) — кратко
Продвижение через ИИ — это не попытка «накормить» интернет нейросетевым текстом. Это дисциплина на стыке классического SEO и AEO/GEO: вы делаете страницы удобными для прямого ответа на запрос и понятными для генеративных систем. Цель — попадать в AI‑ответы (AI Overviews/AI Mode, ChatGPT, Perplexity, Яндекс Нейро/Алиса) и получать трафик, лиды и узнаваемость.
- AEO (Answer Engine Optimization): оптимизация под движки, которые формируют единый ответ.
- GEO (Generative Engine Optimization): «учим» генеративные системы предпочитать наши источники — за счёт структуры, доказательности и доступности.
- База — та же: индексация, скорость, релевантность. Надстройка — чёткие Q/A‑блоки, HowTo, таблицы, разметка Schema.org и корректные правила для ботов.
Когда ИИ помогает: реальные кейсы и ограничения
Кейс 1. B2B‑интегратор (РФ). Цель — заявки из регионов и попадание в ответы «Алисы» и AI‑режимов.
- Что сделали: FAQ на 20+ страницах, HowTo по внедрению, таблицы со сравнением стэков, Schema.org (FAQPage/HowTo/Article), разрешили YandexAdditionalBot и OAI‑SearchBot.
- Результат за 90 дней: +28% небрендового трафика, 17 упоминаний в AI‑ответах по контрольным запросам, +22% к конверсиям в заявки.
Кейс 2. Образовательный IT‑провайдер (EEA). Цель — видимость в AI Overviews и Perplexity.
- Что сделали: на каждой ключевой статье — «короткий ответ» на 500–700 знаков, таблица критериев выбора, HowTo с шагами и временем выполнения, добавили IndexNow и расширили логи 404/5xx.
- Результат за 60 дней: 9 устойчивых цитирований в AI‑ответах, +35% органики из небрендовых запросов, рост CTR в классической выдаче на 1,6 п.п.
Кейс 3. IT‑аутсорсинг (глобально). Цель — лидогенерация через ChatGPT Search и Perplexity.
- Что сделали: раздельные правила для GPTBot (ограничение обучения) и OAI‑SearchBot (разрешение доступа), HowTo/FAQ‑форматы на топ‑кластерах, карточки «TL;DR» на первой прокрутке, BreadcrumbList в JSON‑LD.
- Результат за 120 дней: 21 цитирование, +41% визитов из AI‑источников, доля лидов из AI‑каналов 14% от всего органического атрибута.
Ограничения и риски:
- Нулевой траст и дубли — ИИ редко цитирует, если нет E‑E‑A‑T (автор, опыт, доказательства).
- YMYL‑темы — без проверяемости и экспертности шансы минимальны.
- Автогенерация «ради объёма» — ухудшает качество и снижает вероятность попадания в ответы.
Технические требования: индексация, robots.txt и директивы (пример)
Коротко: если бот не может безопасно прочесть страницу, он не процитирует её в AI‑ответе.
Обязательные проверки на страницу:
- Индексируемость: нет запрета в robots.txt, корректные каноникалы, страница в карте сайта, статус 200, нет «noindex»/«nosnippet» там, где нужен ответ.
- Доступность: скорость TTFB < 800 мс, размер HTML до 200–300 КБ, нет блокирующих скриптов на критическом пути рендера.
- Структура ответа: краткий блок «Суть» в начале, затем развернуто, поддержано цифрами и списками.
- Разметка: добавьте Schema.org под тип контента.
Пример минимальной секции для robots.txt (скелет):
User-agent: *
Allow: /
Disallow: /admin/
Sitemap: /sitemap.xml
Пример управления сниппетом на уровне страницы (HTML):
<meta name="robots" content="max-snippet:300, max-image-preview:large, max-video-preview:-1">Ограничение фрагментов на части текста (атрибуты):
<p data-nosnippet>Этот фрагмент не попадёт в сниппеты.</p>Для документов: заголовок сервера X‑Robots‑Tag может повторять директивы «noindex», «nosnippet», «noai» при необходимости.
Файлы и боты: как управлять GPTBot, OAI‑SearchBot, PerplexityBot и YandexAdditionalBot (с примерами robots.txt)
Разница важна:
- GPTBot — в основном обучение моделей. Не влияет напрямую на показ в выдачах.
- OAI‑SearchBot — доступ к контенту для поиска/цитирования в продуктах ChatGPT.
- PerplexityBot — краулинг для ответов Perplexity.
- YandexAdditionalBot — дополнительное сканирование для поиска и AI‑режимов Яндекса.
Шаблоны robots.txt (адаптируйте под политику):
Разрешить цитирование, но ограничить обучение:
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: YandexAdditionalBot
Allow: /

User-agent: GPTBot
Disallow: /
Запретить всё перечисленным (например, на закрытых разделах):
User-agent: OAI-SearchBot
Disallow: /private/

User-agent: PerplexityBot
Disallow: /private/

User-agent: YandexAdditionalBot
Disallow: /private/

User-agent: GPTBot
Disallow: /private/
Файл llms.txt (политика для LLM). Разместите в корне. Пример:
# Условия использования контента ИИ‑системами
training: disallow
search-citation: allow
contact: legal@your-domain
Важно: запрет обучения не равен запрету индексации классическими поисковыми ботами. Держите эти политики раздельно.
Schema.org и JSON‑LD: готовые фрагменты (Article, FAQPage, HowTo, BreadcrumbList)
Article — для экспертных материалов:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Как выбрать ERP для производства",
  "datePublished": "2026-05-10",
  "dateModified": "2026-10-01",
  "author": {"@type": "Person", "name": "Имя Фамилия"},
  "publisher": {"@type": "Organization", "name": "Компания"}
}
FAQPage — для Q/A‑блоков:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Сколько длится внедрение?",
      "acceptedAnswer": {"@type": "Answer", "text": "Обычно 6–12 недель для пилота."}
    },
    {
      "@type": "Question",
      "name": "Какие гарантии?",
      "acceptedAnswer": {"@type": "Answer", "text": "SLA и поэтапная приёмка работ."}
    }
  ]
}
HowTo — для инструкций шаг за шагом:
{
  "@context": "https://schema.org",
  "@type": "HowTo",
  "name": "Аудит страницы под AI‑выдачу",
  "step": [
    {"@type": "HowToStep", "name": "Проверьте индексируемость", "text": "Статус 200, в карте сайта, Allow в robots."},
    {"@type": "HowToStep", "name": "Добавьте FAQ", "text": "3–5 коротких ответов с разметкой."},
    {"@type": "HowToStep", "name": "Опубликуйте вывод", "text": "TL;DR в начале на 400–700 знаков."}
  ]
}
BreadcrumbList — для крошек и контекста:
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {"@type": "ListItem", "position": 1, "name": "Блог"},
    {"@type": "ListItem", "position": 2, "name": "AI‑оптимизация"},
    {"@type": "ListItem", "position": 3, "name": "Гайд по GEO/AEO"}
  ]
}
Контент‑форматы, которые цитируют нейросети (FAQ, гайды, таблицы, выводы)
Проверенные элементы, повышающие шанс цитирования:
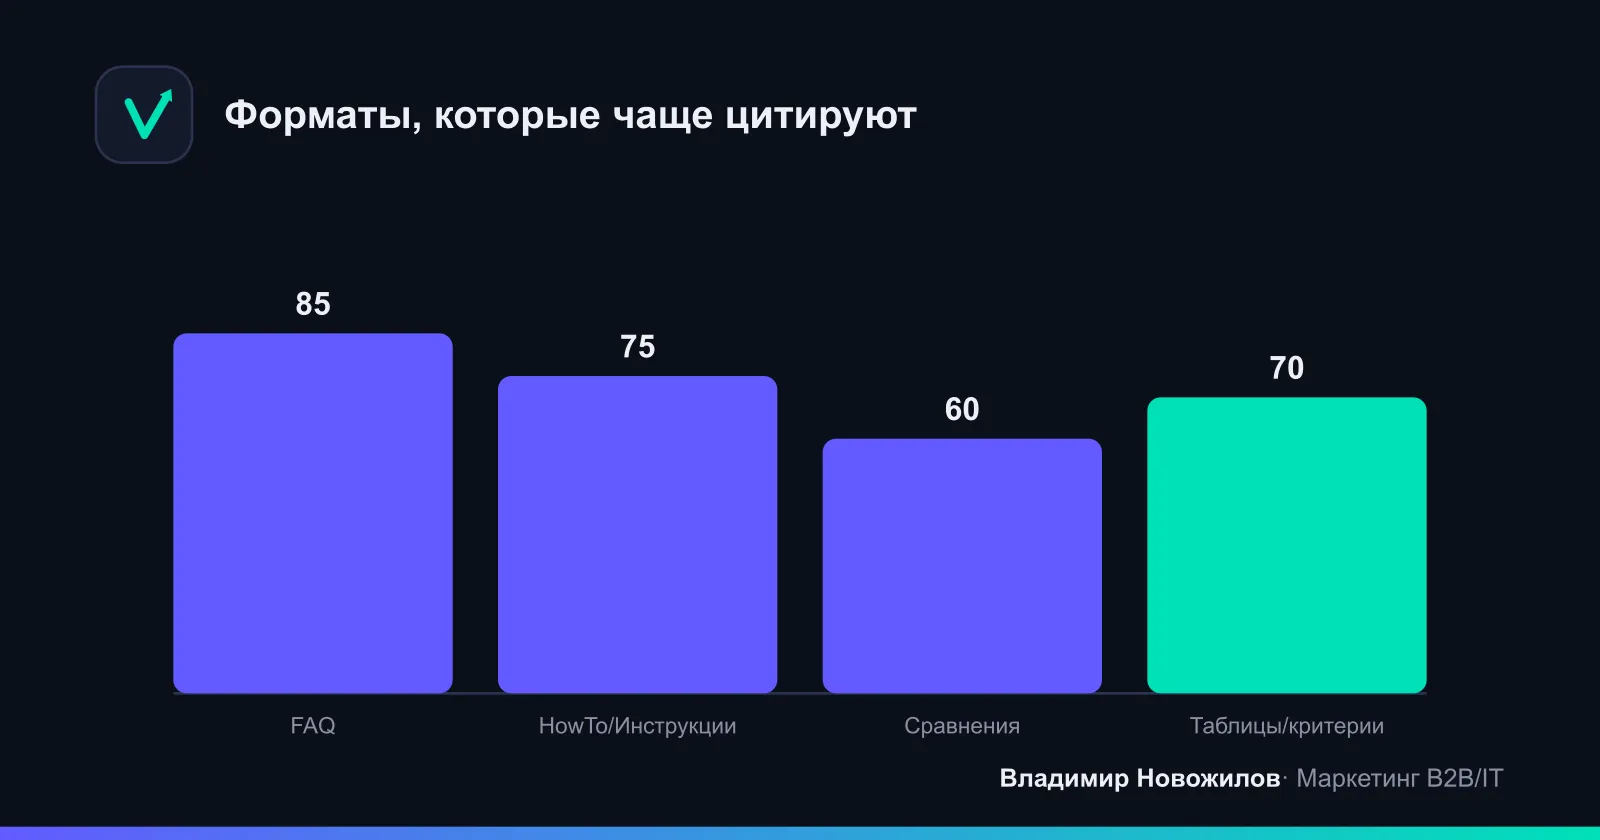
- Короткий ответ вверху: 400–700 знаков, без «воды», с цифрами и критериями.
- FAQ из 3–6 вопросов с самодостаточными ответами.
- HowTo со списком шагов и оценкой времени/сложности.
- Таблица критериев/сравнений: помогает моделям «вынимать» факты.
- E‑E‑A‑T: автор с экспертизой, дата, опыт, кейсы и проверяемость.
Шаблоны: чек‑лист на страницу и пошаговая имплементация (3/3) — таблица
Чек‑лист «страница для AI‑ответов» (отметьте выполненное):
| Этап | Действие | Готово? |
|---|---|---|
| 1. Доступ | Страница индексируема; Allow в robots; в карте сайта | [ ] |
| 1. Доступ | 200 OK, Core Web Vitals в зелёной зоне | [ ] |
| 2. Структура | Короткий ответ (TL;DR) на первом экране | [ ] |
| 2. Структура | FAQ 3–6 пунктов + JSON‑LD FAQPage | [ ] |
| 2. Структура | HowTo со шагами (если применимо) | [ ] |
| 3. Доказательства | Автор/дата, кейс/цифры, ссылки на первоисточники | [ ] |
| 3. Доказательства | Article/BreadcrumbList разметка | [ ] |
| 3. Доказательства | Обновление не реже 1 раза в квартал | [ ] |
Пошаговая имплементация 3/3:
| Шаг | Что делаем | Ответственный | Срок | Статус |
|---|---|---|---|---|
| 1/3 Доступ | Robots, карта сайта, проверка статусов | SEO/Dev | Неделя 1 | [ ] |
| 2/3 Структура | TL;DR, FAQ, HowTo, таблицы | Контент | Недели 2–3 | [ ] |
| 3/3 Доказательства | Автор, кейсы, E‑E‑A‑T, JSON‑LD | Маркетинг | Неделя 4 | [ ] |
Как собирать и проверять источники: требования к E‑E‑A‑T
- Experience: показывайте практический опыт — «как делали», цифры «до/после», названия ролей.
- Expertise: профиль автора, релевантные сертификации и тематика публикации.
- Authoritativeness: упоминания бренда, цитаты, участие в отраслевых обзорах, читабельные методологии.
- Trustworthiness: прозрачные политики, контакты, юридическая информация, свежие даты обновления.
Контрольный список E‑E‑A‑T на раздел «Кто мы»: авторы с должностями, контакты, фото, ссылка на редакционную политику на сайте, дата последней валидации статей.
Инструменты: IndexNow, Bing Webmaster, Search Console, API‑провайдеры LLM
- Google Search Console: заведите все версии домена, проверьте покрытие, загрузите карту сайта, используйте отчёты по эффективности по контрольным кластерам.
- Bing Webmaster Tools: настройте сайт, используйте IndexNow — публикуйте ключ и отправляйте события создания/обновления страниц.
- IndexNow: автоматизируйте пинг при публикации/редактировании; для CMS — подключите веб‑хуки.
- Логи и мониторинг: фиксируйте заходы нужных ботов (OAI‑SearchBot, PerplexityBot, YandexAdditionalBot) и ошибки 4xx/5xx.
- API‑провайдеры LLM: используйте локально для генерации черновиков FAQ/HowTo, последующей ручной доработки и структурирования в JSON.
Как обучать/поддерживать модели на вашем контенте — пример процесса
Цель — сделать контент удобным для извлечения фактов и ответов. Рекомендован подход «структурируем и подсказываем», а не «массово дообучаем».
Процесс:
- Сбор ядра и интентов: сформируйте кластеры вопросов и задач, сгруппируйте под страницы.
- Шаблон контента: для каждого кластера — TL;DR, HowTo, FAQ, таблица критериев, мини‑кейс.
- Разметка JSON‑LD и крошки: Article + FAQPage/HowTo + BreadcrumbList.
- Политика ботов: разрешите боты для цитирования, при необходимости ограничьте обучение.
- Проверка ответов: раз в неделю пройдитесь по контрольным запросам и зафиксируйте цитирования.
Примеры промптов для подготовки контента (используйте на своих материалах):
Промпт 1. TL;DR из статьи
- Задача: выжать 500–700 знаков с критериями и цифрами.
- Формат ответа: 2–3 предложения + маркированный список из 3–5 пунктов.
Промпт 2. HowTo
- Задача: оформить пошаговую инструкцию с оценкой времени.
- Формат ответа: JSON с ключами step, name, time, text.
Промпт 3. FAQ
- Задача: составить 3–6 самодостаточных Q/A разной длины.
- Ограничения: без общих слов, минимум один ответ с цифрами/диапазоном.
Ожидаемый формат JSON для HowTo (пример):
{
  "howto": [
    {"step": 1, "name": "Проверка индексации", "time": "5 мин", "text": "Проверьте статус 200 и наличие в карте сайта."},
    {"step": 2, "name": "Добавить FAQ", "time": "10 мин", "text": "3–5 чётких Q/A с разметкой."}
  ]
}
Как измерять успех: метрики и дашборд цитирований в AI‑ответах
Ключевые метрики:
- AI‑Citations: число цитирований по платформам (Google AI Overviews/AI Mode, ChatGPT, Perplexity, Яндекс).
- AI‑Visibility: доля запросов, где вы попали в AI‑ответ, из выбранного набора.
- AI‑Traffic: сессии/клики из AI‑источников (по UTM и реферальным каналам).
- Lead/Revenue impact: заявки, конверсии и сделки, атрибутированные к AI‑источникам.
Примеры UTM для спец‑лендингов:
- utm_source=ai_overviews&utm_medium=referral&utm_campaign=geo
- utm_source=chatgpt&utm_medium=answer&utm_campaign=howto
- utm_source=perplexity&utm_medium=citation&utm_campaign=faq
Шаблон дашборда (еженедельно):
| Дата | Платформа | Запрос | Позиция/покрытие | Цитирование | Слаг целевой | Сессии | Конверсии |
|---|---|---|---|---|---|---|---|
| 2026‑10‑01 | Google AI | «выбор ERP для SMB» | 1/AI‑ответ | Да | /blog/erp‑smb‑guide | 86 | 3 |
| 2026‑10‑01 | ChatGPT | «сравнение CDN для B2B» | AI Mode | Да | /blog/cdn‑compare | 41 | 1 |
| 2026‑10‑01 | Perplexity | «что такое GEO для сайта» | Ответ | Нет | /blog/geo‑intro | 0 | 0 |
| 2026‑10‑01 | Яндекс | «аудит CRM интеграции» | Нейро | Да | /blog/crm‑audit | 21 | 1 |
Часто задаваемые вопросы (FAQ)
Собственный блок с разметкой FAQ уже выше; здесь — краткие ответы, удобные для GEO/AEO.
-
Что нужно сделать в первую очередь, чтобы страницы могли использоваться в AI‑ответах? Индексируемость, чёткий краткий ответ, FAQ/HowTo, актуальная Schema.org и проверяемость. Затем — контроль ботов и мониторинг цитирований.
-
Нужно ли разрешать GPTBot и OAI‑SearchBot в robots.txt, чтобы ChatGPT использовал мой контент? Разрешайте OAI‑SearchBot, он важен для цитирования. GPTBot — про обучение; решайте по политике контента.
-
Какие форматы контента чаще цитируют нейросети (FAQ, HowTo, таблицы)? FAQ, HowTo, таблицы критериев/сравнений и краткий вывод в начале страницы.
-
Как измерить, ссылается ли нейросеть на мои страницы (контрольные запросы, UTM‑пометки)? Ведите список контрольных запросов и еженедельный дашборд: платформа, запрос, факт цитирования, слаг страницы, сессии и конверсии. Для спец‑лендингов используйте UTM‑метки.
-
Как защитить контент от использования для обучения моделей, если я хочу запретить это? Ограничьте GPTBot в robots.txt, используйте X‑Robots‑Tag и разместите llms.txt с политикой.
Практическая часть: готовые файлы/сниппеты/robots.txt/JSON‑LD
Мини‑набор «копируй‑вставляй» (адаптируйте под себя):
Robots (доступ + политика ИИ):
User-agent: *
Allow: /
Disallow: /admin/
Sitemap: /sitemap.xml

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: YandexAdditionalBot
Allow: /

User-agent: GPTBot
Disallow: /
Заголовки для документов (пример):
X-Robots-Tag: max-snippet:300llms.txt (в корне):
training: disallow
search-citation: allow
contact: legal@your-domain
JSON‑LD блоки (минимальные):
Article:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Название статьи",
  "author": {"@type": "Person", "name": "Автор"},
  "datePublished": "2026-10-01",
  "dateModified": "2026-10-01"
}
FAQPage:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {"@type": "Question", "name": "Вопрос 1", "acceptedAnswer": {"@type": "Answer", "text": "Ответ."}}
  ]
}
HowTo:
{
  "@context": "https://schema.org",
  "@type": "HowTo",
  "name": "Короткая инструкция",
  "step": [
    {"@type": "HowToStep", "name": "Шаг 1", "text": "Действие."}
  ]
}
BreadcrumbList:
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {"@type": "ListItem", "position": 1, "name": "Главная"},
    {"@type": "ListItem", "position": 2, "name": "Раздел"}
  ]
}
Мини‑скрипт проверки страницы (псевдокод):
page = fetch(page_url)
assert status(page) == 200
assert in_sitemap(page)
assert robots_allows(page)
assert has_tldr(page, min_chars=400)
assert has_faq(page, min_items=3)
assert has_schema(page, types=["Article"]) Частые вопросы
- Что нужно сделать в первую очередь, чтобы страницы могли использоваться в AI‑ответах?
- Проверьте доступность и индексацию: открытый robots.txt для нужных ботов, корректные каноникалы, актуальные sitemaps и разметку Schema.org (Article/FAQPage/HowTo). Затем убедитесь, что на странице есть краткий явный ответ, дата/автор и ссылки на первоисточники. В панелях Google и Bing настройте свойства сайта и добавьте контрольные запросы в отслеживание.
- Нужно ли разрешать GPTBot и OAI‑SearchBot в robots.txt, чтобы ChatGPT использовал мой контент?
- Для появления в ChatGPT Search и похожих режимах важен доступ именно OAI‑SearchBot. GPTBot отвечает в основном за обучение моделей. Разрешите OAI‑SearchBot и при желании ограничьте GPTBot. Отдельно не запрещайте обычных поисковых ботов, иначе потеряете базовую индексацию.
- Какие форматы контента чаще цитируют нейросети?
- Чаще всего — FAQ с чёткими Q/A, HowTo с шагами, краткие выводы в начале, таблицы с критериями и сравнениями. Важны структурированность, верифицируемость и семантическая точность. Усильте E‑E‑A‑T: автор, опыт, дата, источники.
- Как измерить, ссылается ли нейросеть на мои страницы?
- Соберите список контрольных запросов и раз в неделю проверяйте выдачи Google AI Overviews/AI Mode, ChatGPT, Perplexity, Яндекс (Нейро/Алиса). Фиксируйте цитаты, домены‑источники, слаги целевых страниц. Добавьте UTM‑метки для специальных лендингов и метки кампаний в аналитике.
- Как защитить контент от использования для обучения моделей, если я хочу запретить это?
- В robots.txt запретите ботов обучения (например, GPTBot) и используйте заголовки X‑Robots‑Tag с директивами для ИИ. Дополнительно публикуйте llms.txt с условиями. Учтите: запрет на обучение не равен запрету на индексирование классическими поисковыми ботами.