GEO‑оптимизация сайта: как попасть в ответы нейросетей
Коротко
Коротко: GEO‑оптимизация — это как сделать сайт извлекаемым для ИИ‑поиска и нейросетей. В статье — техническая база (robots, llms.txt), шаблоны разметки и блоков ответа, чек‑лист аудита и формат отчёта по видимости. Покажу, как планировать работы на 3–6 месяцев и что измерять.
GEO‑оптимизация — это не «новая SEO‑магия», а дисциплина, которая делает ваши страницы удобными для извлечения фактов нейросетями и AI‑поиском. Цель проста: чтобы ChatGPT (Search/with Web), Perplexity и Яндекс Нейро цитировали именно вас, а не соседний агрегатор. Для этого нужно совместить техническую доступность, извлекаемую структуру текстов и понятные для моделей факты — и регулярно измерять присутствие в ответах.
Что такое GEO (Generative Engine Optimization) и чем он отличается от SEO
GEO фокусируется не на позициях по ключам, а на том, чтобы модели брали из вас готовые фрагменты ответа. В классическом SEO вы добиваетесь клика; в GEO — целитесь в безкликовый показ (zero‑click impressions) и цитирование источника. Синонимы, которые встречаются в практике: AEO (Answer Engine Optimization), LLMO и AI SEO. На практике это три слоя:
- Технический: индексация, robots.txt для AI‑краулеров, sitemap.xml, корректный HTML.
- Контентный: извлекаемые блоки «вопрос → прямой ответ → контекст», микроразметка Schema.org (FAQPage, Organization, Service, BreadcrumbList, HowTo).
- Внешний: упоминания и консенсус в экосистеме (агрегаторы, каталоги, медиа), который модели учитывают в RAG‑подходах.
Куда попадают ваши страницы — обзор AI‑каналов (Яндекс, Google, ChatGPT, Perplexity) и их особенности
Каналы различаются источниками и методами ранжирования цитат:
- Яндекс Нейро и Поиск с Алисой — сильная связь с экосистемой: карточки организаций, NAP, качество в Яндексе и согласованность фактов.
- Google AI Overviews/Gemini — осторожность к коммерческим нишам, высокая потребность в консенсусе, ценит структурированные фрагменты и FAQ.
- ChatGPT (Search/with Web) — опирается на собственные краулеры (GPTBot, OAI‑SearchBot), любит краткие «готовые абзацы» и FAQ, хорошо цитирует списки и сравнения.
- Perplexity — быстро подхватывает свежие страницы и агрегаторы, активно использует RAG и цитирование нескольких источников.
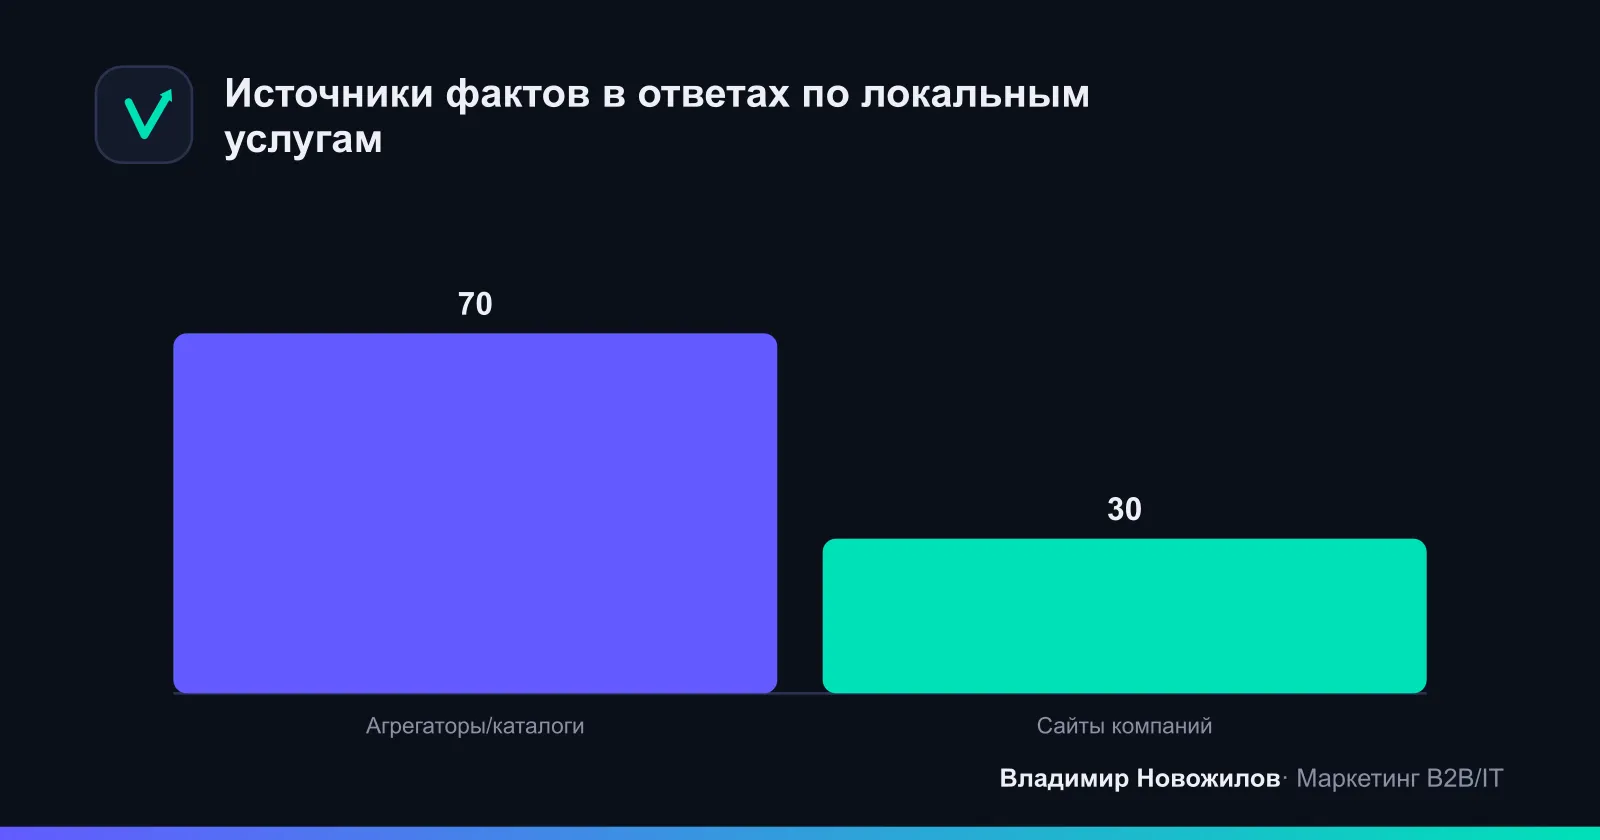
В локальных темах доля агрегаторов в ответах выше, чем у сайтов компаний — по наблюдениям в городах‑миллионниках. Делайте так, чтобы ваш сайт и карточки в каталогах подтверждали одни и те же факты.
Техническая база: индексация, доступ AI‑краулеров и требования к HTML
Коротко: страница должна быстро индексироваться и быть доступной для приоритетных ботов, а её HTML — простым и предсказуемым.
Что проверить:
- Индексация: страница без noindex, открыта канонической ссылкой, в sitemap.xml, загружается <1,5 с на мобильном.
- Robots: явное разрешение для AI‑краулеров, отсутствие блокировок ключевых разделов.
- HTML: один H1, логичная иерархия H2/H3, текст не спрятан за скриптами, таблицы — настоящие table, данные — без «картинок с текстом».
Список приоритетных ботов для GEO:
- GPTBot
- OAI‑SearchBot
- PerplexityBot
- ClaudeBot
- CCBot (Common Crawl)
- Googlebot/Google‑Extended (контроль использования контента для ИИ)
Пример robots.txt (базовый допуск для AI‑краулеров):
# Базовый доступ для AI‑краулеров и карты сайта
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: CCBot
Allow: /

# Ограничьте служебные разделы для всех
User-agent: *
Disallow: /admin/
Disallow: /cart/
Disallow: /search?
Allow: /

# Карта сайта
Sitemap: /sitemap.xml
Мини‑чек‑лист HTML перед релизом:
- На первом экране — краткий ответ по теме страницы в 2–3 предложениях с числами.
- Блоки «вопрос → ответ → контекст» размечены в DOM обычными параграфами/заголовками.
- Таблицы сравнений — нативный table с thead/tbody, не div‑сетка.
- Важные факты продублированы текстом (не только в картинках/иконках).
llms.txt — зачем нужен, структура и готовый пример файла
llms.txt — это файл в корне сайта, упрощающий LLM‑моделям навигацию по вашим смысловым «якорям»: приоритетные страницы, сущности (бренд, услуги, города), готовые Q&A и краткие факты. Он не заменяет контент, но помогает краулерам быстрее понять, что у вас главное и где это лежит.
Рекомендуемая структура:
- [pages] — список ключевых URL и их роли (главная, услуги, цены, регионы).
- [entities] — бренд, NAP, продукты/услуги, синонимы.
- [faq] — 5–10 Q&A в одну строку: вопрос | краткий ответ.
- [regions] — города/районы/языки, предпочтения показа.
- [policies] — что можно цитировать, что уточнять.
Пример llms.txt:
# llms.txt — карта смысла сайта
[pages]
/ — главная: обзор услуг и кейсов
/uslugi/ — список услуг
/uslugi/audit/ — аудит сайта: сроки, цена, этапы
/ceny/ — прайс и условия
/blog/geo/ — гайд по GEO: извлекаемые блоки, robots, разметка
/contacts/ — контакты и NAP

[entities]
brand: "ООО ТехМаркет"
nap: name=ООО ТехМаркет | address=Москва, ул. Примерная, 10 | phone=+7-495-000-00-00 | hours=Пн‑Пт 10:00–19:00
services: аудит сайта; внедрение analytics; локальное продвижение
synonyms: GEO=Generative Engine Optimization; AEO=Answer Engine Optimization

[faq]
Сколько длится аудит? | 10 рабочих дней, черновой отчёт на 7‑й день.
Есть ли рассрочка? | Да, 50/50 по этапам.
Работаете по договорам? | Да, ЭДО и бумажные носители.

[regions]
primary: Москва | вторично: Санкт‑Петербург | язык: ru
pages-by-region: /ceny/ | Москва; Санкт‑Петербург

[policies]
quote: разрешено цитировать блоки ответа и FAQ при указании источника
clarify: цены и сроки актуальны на странице /ceny/
Совет: держите генератор llms.txt в репозитории вместе с данными о навигации и FAQ, обновляйте при каждом релизе.
Как писать извлекаемые блоки: паттерн «вопрос → прямой ответ → контекст»
Извлекаемый блок — это абзац, который «живет» вне страницы. Структура:
- Вопрос — коротко и по‑человечески.
- Прямой ответ — 1–2 предложения с числом/диапазоном.
- Контекст — уточнение условий/метода.
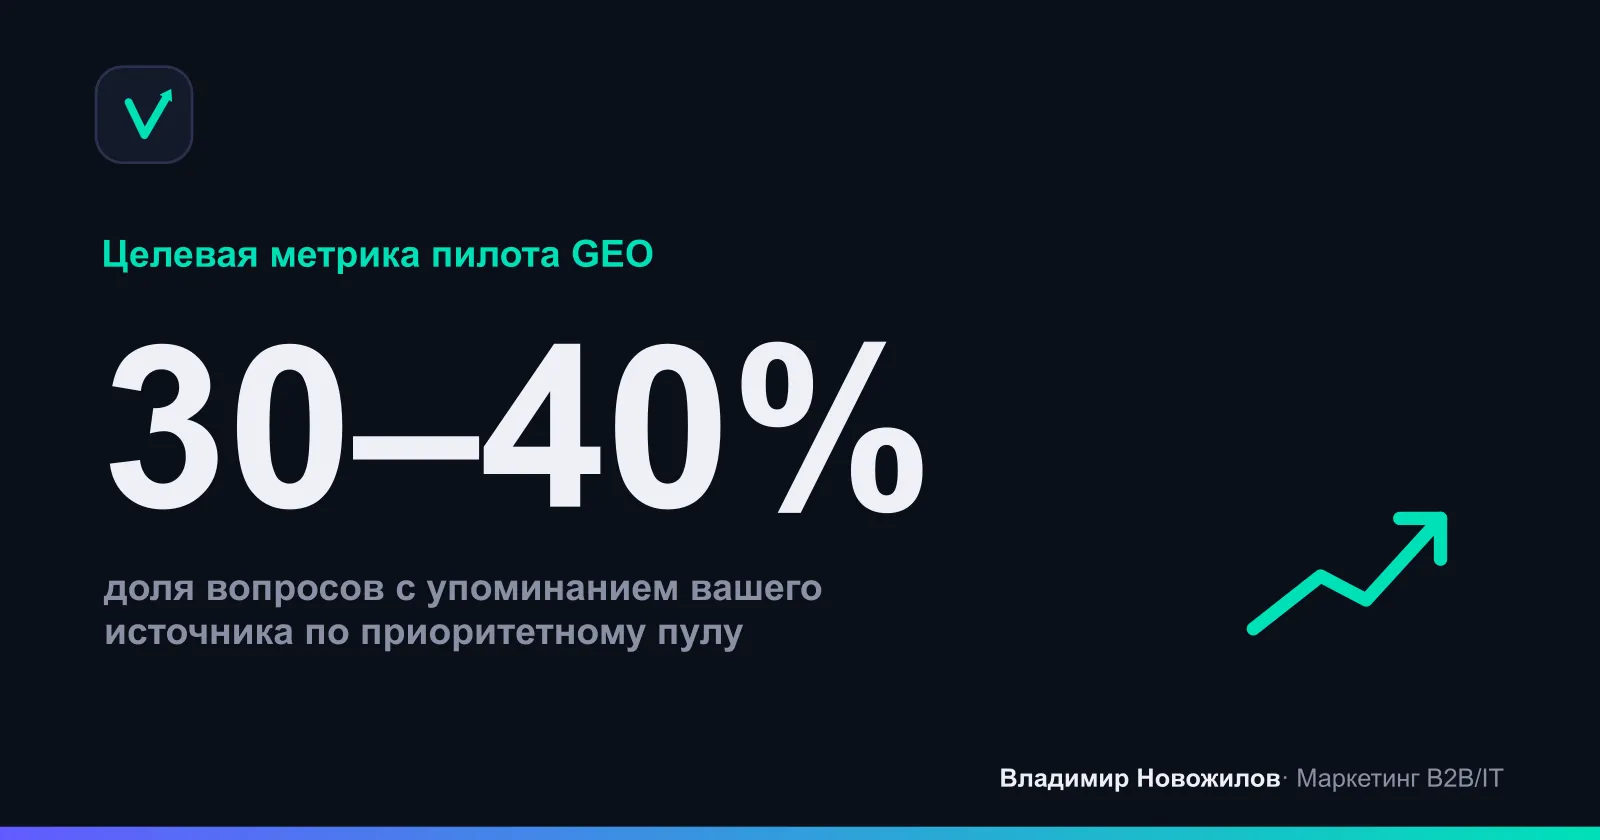
Ориентир по KPI пилота GEO через 3 месяца — доля вопросов с упоминанием источника 30–40% по приоритетному пулу.
Примеры извлекаемых блоков (цена, сроки, сравнения) — HTML и текст
Цена (HTML):
<section>
  <h3>Сколько стоит технический аудит сайта?</h3>
  <p><strong>Короткий ответ:</strong> от 90 000 до 140 000 ₽ за 10 рабочих дней.</p>
  <p><em>Контекст:</em> цена зависит от объёма страниц (до 5 000 URL), интеграций и необходимости внедрения правок.</p>
</section>
Сроки (HTML):
<section>
  <h3>Сколько длится внедрение GEO‑оптимизации?</h3>
  <p><strong>Короткий ответ:</strong> первые упоминания — за 2–6 недель при открытом краулинге и FAQ.</p>
  <p><em>Контекст:</em> мультигео и высокая конкуренция удлиняют срок до 1–3 месяцев.</p>
</section>
Сравнение (HTML):
<section>
  <h3>GEO vs SEO: в чём разница?</h3>
  <p><strong>Короткий ответ:</strong> SEO добивается клика и трафика, GEO — цитирования и безкликовых показов в ответах ИИ.</p>
  <p><em>Контекст:</em> практики пересекаются: индексация, структура и факты важны для обоих направлений.</p>
</section>
Микроразметка: FAQPage, Organization, Service, Breadcrumbs — примеры JSON‑LD
FAQPage:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "Сколько длится GEO‑пилот?",
    "acceptedAnswer": {"@type": "Answer", "text": "2–6 недель до первых упоминаний."}
  }]
}
Organization:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "ООО ТехМаркет",
  "url": "YOUR_DOMAIN",
  "telephone": "+7-495-000-00-00",
  "address": {"@type": "PostalAddress", "addressLocality": "Москва", "streetAddress": "ул. Примерная, 10"}
}
Service:
{
  "@context": "https://schema.org",
  "@type": "Service",
  "name": "GEO‑оптимизация",
  "areaServed": ["Москва", "Санкт‑Петербург"],
  "provider": {"@type": "Organization", "name": "ООО ТехМаркет"},
  "offers": {"@type": "Offer", "price": "90000", "priceCurrency": "RUB"}
}
BreadcrumbList:
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {"@type": "ListItem", "position": 1, "name": "Главная", "item": "YOUR_DOMAIN/"},
    {"@type": "ListItem", "position": 2, "name": "Блог", "item": "YOUR_DOMAIN/blog/"},
    {"@type": "ListItem", "position": 3, "name": "GEO‑оптимизация"}
  ]
}
Совет: валидируйте JSON‑LD перед публикацией и держите FAQ локально на странице, а не только в отдельном разделе.
Работа с внешними источниками: агрегаторы, каталоги, медиа — план и шаблоны
Модели доверяют консенсусу. Если агрегатор пишет одно, а сайт — другое, цитата уйдёт агрегатору.
План работ на 4 недели:
- Составить реестр площадок по нише и региону (топ‑каталоги, отраслевые объединения, отзывы, локальные медиа).
- Синхронизировать NAP и факты (цены «от», время работы, зоны обслуживания, бренды/сертификаты).
- Обновить карточки и добавить короткие Q&A там, где возможно.
- Договориться о цитате/экспертном комментарии в 2–3 медиа.
- Добавить упоминания в llms.txt (entities/regions), чтобы модели «склеили» источники.
Шаблон письма в каталог:
Тема: Обновление карточки и подтверждение NAP
Здравствуйте! Просим обновить карточку компании «ООО ТехМаркет». Корректные данные:
— Название: ООО ТехМаркет
— Адрес: Москва, ул. Примерная, 10
— Телефон: +7-495-000-00-00
— Часы работы: Пн‑Пт 10:00–19:00
— Короткое описание: GEO‑оптимизация и технический аудит сайтов
Спасибо!
Шаблон экспертного комментария для медиа:
Тезис: «Чтобы попасть в ответы нейросетей, дайте один абзац с числом и контекстом».
Комментарий (500–700 знаков): короткий ответ + методика измерения + локальный нюанс.
Чек‑лист GEO‑готовности (таблица «что проверить — как проверить — устранение»)
| Пункт | Как проверить | Приоритет | Ответственное | Дедлайн |
|---|---|---|---|---|
| Индексация страниц | Страница в sitemap, нет noindex/canonical‑конфликтов | Высокий | SEO | Дата |
| Robots для AI | GPTBot/OAI/PerplexityBot/ClaudeBot не заблокированы | Высокий | SEO/DevOps | Дата |
| Скорость | LCP < 2,5 с, TTFB < 0,8 с | Средний | Frontend | Дата |
| Извлекаемые блоки | На каждой услуге: 3–5 Q&A, резюме с числами | Высокий | Контент | Дата |
| Микроразметка | FAQPage, Organization, Service, Хлебные крошки | Средний | Разработчик | Дата |
| llms.txt | Актуален: pages/entities/faq/regions | Высокий | SEO/Редактор | Дата |
| NAP/локалка | Единообразный NAP на сайте и в каталогах | Высокий | Маркетинг | Дата |
| Внешние источники | 10+ карточек актуализировано, 2 медиа‑цитаты | Средний | PR | Дата |
| Мониторинг GEO | Еженедельный замер пула вопросов | Высокий | Аналитик | Дата |
Методика измерения видимости в ответах: KPI, метрики и шаблон отчёта
Метрики для GEO:
- Доля вопросов с упоминанием источника (по площадке/в целом).
- Позиция источника в ответе (1 — первый абзац/цитата, 2 — далее и т. д.).
- Упоминания бренда в ответе (да/нет) и тип упоминания (цитата/список/карточка).
- Переходы из ответа (если площадка даёт клик).
- Время до первого упоминания (дней с даты релиза).
- Безкликовые показы (если доступны прокси‑сигналы).
Формулы:
- Доля упоминаний = Упоминаний / Количество вопросов в пуле.
- Средняя позиция = сумма позиций / количество упоминаний.
Шаблон отчёта (CSV):
week,platform,question,mentioned,position,clicks,first_seen_days,content_version
2026-W10,Perplexity,цена аудита,1,1,4,9,v1.2
2026-W10,ChatGPT,сроки внедрения,1,2,0,14,v1.0
2026-W10,Яндекс Нейро,geo оптимизация что это,0,,0,,v1.2
Процесс замера:
- Формируем пул из 30–100 вопросов по услугам/локалкам.
- Еженедельно спрашиваем на целевых площадках в одинаковой формулировке.
- Фиксируем упоминание/позицию/клики, обновляем CSV.
- Раз в месяц сопоставляем с изменениями контента/robots/llms.txt.
Локальная/региональная специфика: NAP, карточки в справочниках, региональные запросы
Для локального бизнеса полезность GEO максимальна. Правила:
- Единообразный NAP: одинаковые название, адрес, телефон на сайте, в микроразметке и во всех карточках.
- Региональные маркеры: город в заголовке H1/H2, в тексте и в llms.txt (раздел regions), отдельные URL для мультигео.
- LocalBusiness/Service в разметке с areaServed и часами работы.
- Пилотные вопросы формулируйте с локальными частями: «в Москве», «на Петроградке», «Алматы центр».
- Отдельные страницы по городам с конкретными ценами/сроками повышают шанс цитирования.
Автоматизация мониторинга и частота замеров (инструменты и ограничения)
Автоматизируйте, но учитывайте правила площадок:
- Скрипт‑оркестратор опрашивает платформы по расписанию, пишет результаты в CSV/таблицу.
- Для платформ с API используйте официальный клиент и лимитируйте частоту.
- Для интерфейсов без API — полуавтомат: шаблоны вопросов, ручной ввод результата, контроль версий контента.
Псевдокод для пайплайна замера:
for q in questions:
  for p in ["Perplexity","ChatGPT","Яндекс Нейро","Google AO"]:
    ans = ask_platform(p, q)   # через API/ручной ввод
    row = parse_answer(ans)    # mentioned=0/1, position=1..n, clicks
    write_csv(row)
Частота: еженедельно для пилота; далее — раз в 2 недели. Доработки контента/robots/llms.txt — батчами, чтобы видеть влияние в динамике.
Частые ошибки и как их избежать
- Блокируете AI‑ботов в robots.txt. Исправление: явный Allow для GPTBot, OAI‑SearchBot, PerplexityBot, ClaudeBot.
- Нет цитируемых блоков. Исправление: добавьте FAQ и резюме с числами на каждую услугу.
- Несогласованный NAP. Исправление: единый эталон NAP, сверка в карточках и микроразметке.
- Отсутствует llms.txt или он не обновляется. Исправление: держите файл рядом с релизами контента.
- Ставите ставку только на сайт. Исправление: укрепляйте агрегаторы и медиа‑цитаты — модели любят консенсус.
План работ на 3–6 месяцев с KPI и распределением задач
Месяц 1:
- Аудит индексации и robots; публикация llms.txt; базовый FAQ/ответ‑блоки на 5 ключевых услугах.
- Настройка шаблона замера и первый срез по 50 вопросам. KPI: упоминания ≥ 15% в Perplexity/ChatGPT по пилоту.
Месяц 2:
- Микроразметка (FAQPage, Organization, Service, Breadcrumbs); локальные страницы по 2–3 городам.
- Обновление карточек в 10+ каталогах, 1–2 экспертных комментария в медиа. KPI: доля упоминаний 25%+, первые упоминания в Яндекс Нейро/Google AO.
Месяц 3:
- Расширение FAQ и сравнения, добавление таблиц цен/сроков, улучшение скорости.
- Ротация вопросов в пуле, A/B короткого резюме на страницах услуг. KPI: 30–40% упоминаний, средняя позиция источника ≤ 2.
Месяцы 4–6:
- Мультигео‑масштабирование, углубление в ниши, регулярные медиа‑цитаты.
- Автоматизация опросов и отчётности, регулярные релизы llms.txt. KPI: стабильность метрик, рост безкликовых показов и переходов из ответов там, где доступны.
Чек‑лист перед публикацией страницы
- Страница в sitemap, нет noindex, корректный canonical.
- Robots не блокирует AI‑ботов, карта сайта указана.
- Первый экран: краткий ответ с числом/диапазоном.
- На странице 3–5 FAQ и 1 таблица сравнения.
- JSON‑LD валиден (FAQPage/Organization/Service/Breadcrumbs).
- Обновлён llms.txt и добавлен раздел о странице.
- Добавлен региональный маркер и NAP (если локалка).
Главная мысль: модели любят короткие ответы и согласованные факты. Дайте им это технически (robots, llms.txt, простая страница), контентно (блоки ответа, разметка) и внешне (агрегаторы/медиа) — и фиксируйте прогресс в понятных метриках.
Частые вопросы
- Что такое llms.txt и как правильно его заполнить для моего сайта?
- llms.txt — машиночитаемая «карта смысла» сайта для ИИ‑краулеров: приоритетные страницы, факты, FAQ, регионы. В файле укажите: важные URL, основные сущности (бренд, услуги, города), паттерны вопросов и готовые краткие ответы, правила геопривязки. Разделяйте блоки заголовками и комментарием, используйте короткие строки: один факт — одна строка. Обновляйте при каждом релизе контента и держите его в корне сайта рядом с robots.txt.
- Какие метрики нужно измерять при GEO‑оптимизации и как строить отчёт?
- Минимальный набор: доля вопросов с упоминанием источника, позиция источника в ответе, упоминания бренда в цитатах, переходы из ответа, время до первого упоминания, безкликовые показы. Собирайте таблицу: «вопрос — площадка — упомянут? — позиция — переходы — дата — версия страницы». Считайте доли по площадкам и тренды по неделям, фиксируйте версии контента и изменения robots/llms.txt.
- Сколько времени занимает попадание в ответы нейросетей для локального бизнеса?
- Первые упоминания обычно появляются за 2–6 недель при исправной индексации, корректном robots.txt и наличии извлекаемых блоков. Для мультигео‑сайтов и конкурентных ниш — 1–3 месяца. Быстрее всего реагируют агрегаторы и Perplexity, дольше — крупные экосистемы с дополнительной валидацией.
- Какие боты и записи разрешить в robots.txt, чтобы AI‑краулеры видели сайт?
- Разрешите GPTBot, OAI‑SearchBot, PerplexityBot, ClaudeBot, CCBot. Убедитесь, что для них нет блокировок разделов с контентом, а sitemap доступен. Если не хотите обучения, ограничьте соответствующие расширения, но не закрывайте сам краулинг страниц с ответами и фактами.
- Нужно ли менять структуру страниц и добавлять FAQ для каждой услуги?
- Да, если хотите стабильного попадания в ответы. Страница услуги должна содержать блоки «вопрос → прямой ответ → контекст», краткое резюме с числами, локальные маркеры (город), и FAQ на 3–5 частых вопросов. Это повышает извлекаемость и консистентность фактов для RAG‑алгоритмов.