Как попробовать вайбкодинг бесплатно: инструменты, запуск и цены
Коротко
Бесплатный старт реален: начните локально на своём ПК или онлайн на пробных лимитах. В статье — где взять пробный баланс, как запустить Ollama/LM Studio/HF Agent, какие бесплатные модели подойдут и сколько стоит продакшн. Сравнения, таблицы и чек‑листы.
Разбираю, как запустить вайбкодинг без затрат: где удобнее стартовать локально и в облаке, какие инструменты взять, где получить пробный баланс, как подобрать модель и как посчитать расходы в продакшне. Если хотите обойтись без платежей на первых шагах — начинайте локально; облако подключайте там, где важны скорость, качество и масштаб.
Что такое вайбкодинг и зачем пробовать бесплатно
Вайбкодинг — практичный способ собирать рабочие прототипы и приложения на базе ИИ‑моделей и промптов вместо полноценной разработки «с нуля». Имеет смысл попробовать бесплатно, чтобы:
- понять, тянет ли ваша машина нужную модель и задачу;
- оценить пробные лимиты и ограничения облачных провайдеров до оплаты тарифа;
- сравнить качество ответов и латентность без финансовых рисков.
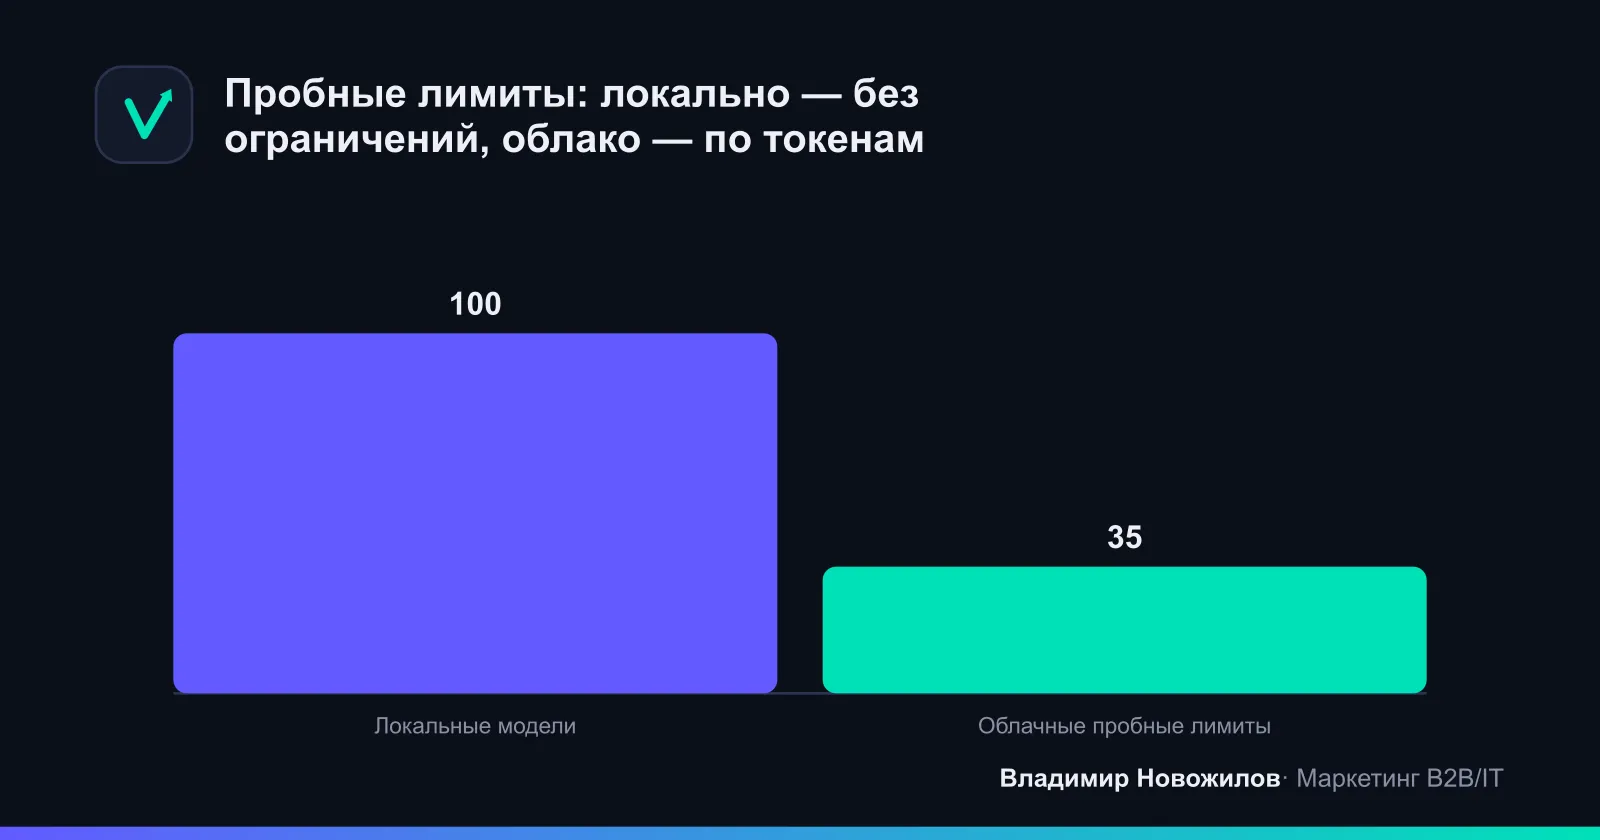
Смысловой баланс такой: локальные модели дают «0 RUB» за инференс, но требуют ресурсов ПК; облачные сервисы обеспечивают быстрый старт и пробный баланс, но ограничивают токены и скорость.
Коротко: как и где попробовать вайбкодинг бесплатно — онлайн и локально
- Локально: Ollama, LM Studio, HF Agent — бесплатные бэкенды, где вы скачиваете модель и запускаете её у себя. Подходит для работы VibeCoding в VS Code без внешнего API.
- Онлайн: облачные модели с пробными лимитами (OpenAI, Claude, региональные агрегаторы вроде Ругент). Это запуск без установки софта.
- Комбинированно: локальная разработка + облачный деплой. Валидируем идею бесплатно локально, затем переносим часть нагрузки в облако.
Сравнение инструментов и моделей — таблица: пробные лимиты, ограничения и цены
Ниже — сводка по популярным вариантам: пробные лимиты, ограничения и ориентиры по ценам. Цены приведены в RUB и USD для сравнения (курс округлён). Перед использованием уточняйте тарифы в интерфейсах сервисов.
| Инструмент/модель | Тип | Пробный лимит | Ограничения | Стоимость после пробного | Преимущества |
|---|---|---|---|---|---|
| Ollama | Локальный бэкенд | Неограничен | Требует 8–16+ ГБ ОЗУ/VRAM; скорость зависит от ПК | 0 RUB | Простая установка, широкий зоопарк моделей |
| LM Studio | Локальный бэкенд (GUI) | Неограничен | Хранение моделей на диске, CPU/GPU требования | 0 RUB | Удобный UI, Windows/Mac, локальный сервер API |
| HF Agent / Inference (Hugging Face) | Локально/облако | Есть бесплатные квоты | Может потребоваться ключ; скорость квоты ниже | От 0 RUB / облако по тарифам | Гибкость, много моделей и провайдеров |
| OpenAI (gpt‑4o/mini) | Облако | Пробный баланс (по условиям региона) | Верификация карты, лимиты токенов | от ~0,2–5 USD за 1K токенов | Качество, инструменты, API |
| Claude (3.x) | Облако | Пробный лимит (по аккаунту) | Могут требовать карту; региональные ограничения | от ~0,8–15 USD за 1M токенов ввода | Длинный контекст, сильный reasoning |
| Ругент | Облачный агрегатор | Пробный баланс | Лимит токенов и времени | Тарифы в RUB, оплата СБП/карта | Удобно для РФ, единый кабинет |
| VibeCoding (VS Code extension) | Клиент/плагин | Бесплатно | Нужен бэкенд: локальный или облачный | 0 RUB за плагин | Быстрый старт, локальная интеграция |
| Llama 3.2 (3B/8B) | Модель | Неограничено локально | Качество vs 70B ниже; нужна RAM | 0 RUB локально | Сбалансированные open‑weights |
| Mistral 7B | Модель | Неограничено локально | 7B требует ~8–12 ГБ RAM (CPU) | 0 RUB локально | Хорошая скорость/качество |
| Phi‑3 (Mini/Small) | Модель | Неограничено локально | Компактные размеры, но могут «галлюцинировать» | 0 RUB локально | Очень шустрые на CPU |
| TinyLlama 1.1B | Модель | Неограничено локально | Базовое качество, короткие ответы | 0 RUB локально | Молниеносно и экономно |
Примечание по оплате для РФ: где требуется оплата, чаще доступны рубль (RUB) и СБП. В зарубежных кабинетах — USD. Проверяйте способы оплаты и закрывающие документы.
Локальные бэкенды: пошаговый quickstart (Ollama, LM Studio, HF Agent) — команды и требования
Ниже — короткий quickstart по трём практичным путям.
Ollama: быстрый старт
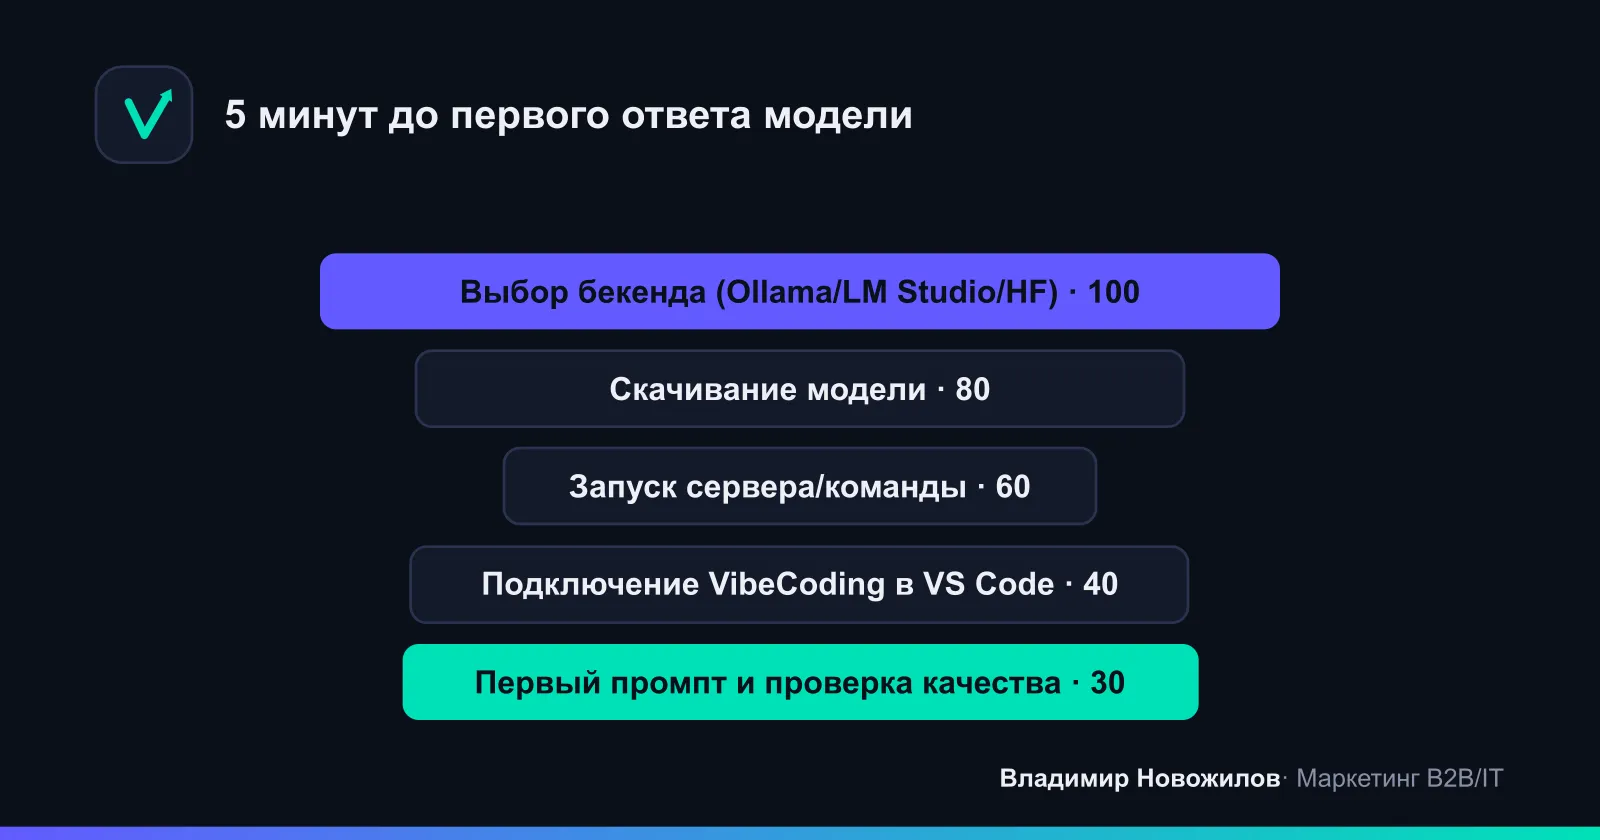
- Требования: Windows/Mac/Linux; CPU с AVX2; 8+ ГБ RAM (для 3–4B), 16+ ГБ RAM (для 7–8B). GPU ускоряет, но не обязателен.
- Установка:
# macOS (brew)
brew install ollama
ollama serve

# Ubuntu/Debian
curl -fsSL https://ollama.com/install.sh | sh
ollama serve

# Windows (через установщик): запустите Ollama и перезапустите терминал- Первая модель:
# Быстрый старт с Mistral 7B (умеренное качество и скорость)
ollama run mistral

# Компактно и быстро
ollama run phi3

# Сбалансированная Llama 3.2 3B
ollama run llama3.2:3b- HTTP API для VibeCoding локально:
# Сервер обычно слушает http://127.0.0.1:11434
# В VibeCoding укажите provider: Ollama и имя модели (например, mistral)
LM Studio: быстрый старт
- Требования: Windows/Mac; 8–16+ ГБ RAM; для ускорения — GPU.
- Шаги:
- Скачайте приложение и установите.
- В каталоге моделей найдите Llama 3.2 3B, Mistral 7B или Phi‑3 Mini.
- Нажмите Download, затем Start Server (порт укажет приложение).
- В VibeCoding выберите LM Studio как провайдера и нужную модель из списка.
- Проверка через curl:
curl http://127.0.0.1:1234/v1/modelsHugging Face (HF Agent / Inference API)
- Вариант 1: локальный HF Agent с transformers.
pip install transformers accelerate torch --upgrade
# Пример запуска через Python: загрузка модели и локальный inference- Вариант 2: Hugging Face Inference API.
- Плюсы: много поддерживаемых моделей и гибкий роутинг. Минусы: квоты и пониженная скорость в бесплатном режиме.
Советы по ресурсам:
- 3B–4B модели комфортны на 8–12 ГБ RAM; для 7B лучше 16 ГБ+ или GPU.
- Квантизация (Q4_K_M и т. п.) снижает требования к памяти при минимальной потере качества.
Облачные пробные варианты и где получить пробный баланс (Ругент, OpenAI, Claude и др.)
Где‑то дают фиксированный пробный лимит, где‑то — «пробный баланс» в валюте кабинета. Для РФ актуальны рублёвые кабинеты и СБП. Онлайн‑подход удобен, чтобы быстро оценить качество без установки.
- Ругент: региональный кабинет с оплатой в рублях, иногда доступен пробный баланс. Подходит для первых экспериментов и сравнения провайдеров.
- OpenAI: как правило, нужна верификация карты; пробные лимиты зависят от региона и статуса аккаунта.
- Claude: аналогично — бесплатные лимиты для чата/API, условия меняются по времени и типу аккаунта.
- Hugging Face: бесплатные квоты на Inference/Spaces, но скорость ниже, чем на платных планах.
Обязательно проверьте политику данных и соответствие требованиям GDPR/локального законодательства: где хранятся логи и разрешено ли коммерческое использование.
Бенчмарк: какие бесплатные модели подходят для вайбкодинга (скорость/качество/память)
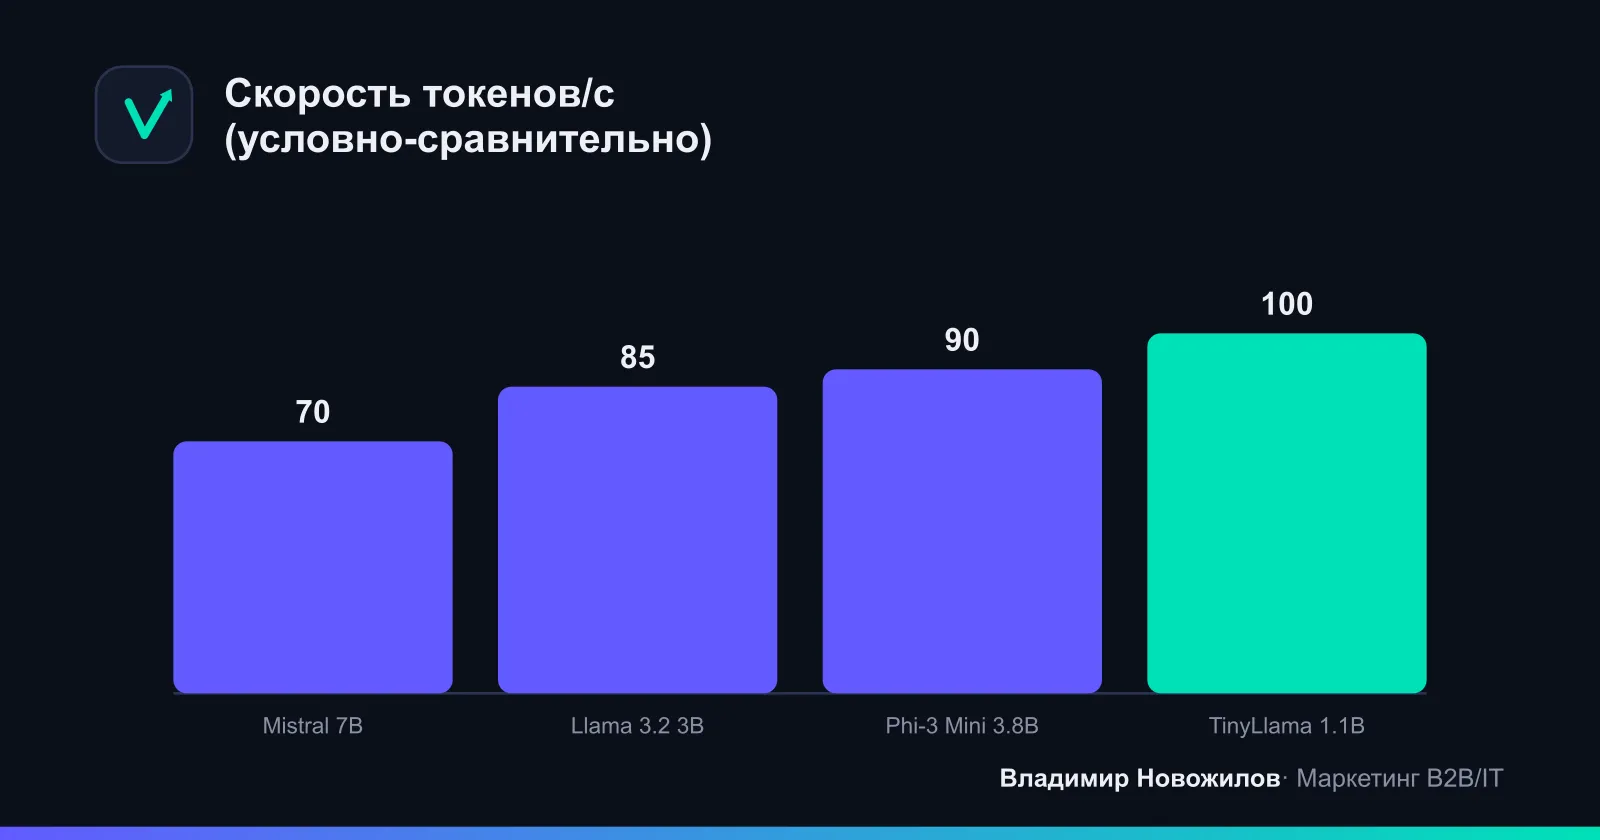
Мини‑замеры на ноутбуке: CPU 8‑ядер, 16 ГБ RAM (без дискретного GPU). Цели: чат по коду/тексту, черновики функций, правка промптов.
| Модель | Память (ОЗУ, ориентир) | Скорость (токен/с, относит.) | Качество для кода | Комментарии |
|---|---|---|---|---|
| TinyLlama 1.1B | 2–4 ГБ | 100 | Низкое | Отлична для быстрых черновиков и утилитных задач |
| Phi‑3 Mini 3.8B | 6–8 ГБ | 90 | Низк.-среднее | Сильна в кратких задачах и генерации прототипов |
| Llama 3.2 3B | 8–10 ГБ | 85 | Среднее | Баланс скорости и связности |
| Mistral 7B | 12–16 ГБ | 70 | Средне‑высокое | Качественные подсказки по коду; медленнее без GPU |
Важно: относительные скорости зависят от квантизации и железа. Для серверной генерации и длинного контекста предпочтительнее Mistral 7B или Llama 3.2 8B с GPU.
Практическая инструкция: собрать первый проект на пробном балансе — чек‑лист и шаблоны промптов
Чек‑лист
- Цель: чётко сформулируйте ожидаемый результат (бот, автозаполнение, простой API).
- Среда: выберите локальный бэкенд (Ollama/LM Studio) или облако с пробным лимитом.
- Модель: начните с Llama 3.2 3B или Mistral 7B.
- Контекст: подготовьте 2–3 пары примеров входа/выхода и решите, нужен ли строгий JSON.
- Интеграция: установите VibeCoding (VS Code extension) и подключите локальный сервер.
- Логи: сохраняйте запросы/ответы для отладки и сравнения качества.
- Безопасность: маскируйте ключи и проверьте лицензию модели на коммерческое использование.
Шаблоны промптов (copy‑paste)
Базовый системный промпт для кода:
Ты — помощник по вайбкодингу. Пиши кратко, без воды. Форматируй ответ в виде шагов.
Если просит код — сначала план (3–5 пунктов), затем код. Используй комментарии.
Генерация функции с тестом:
Задача: Напиши функцию на Python, которая валидирует email через regex.
Формат ответа: план + код функции + unit-тест pytest.
Ограничения: без внешних зависимостей, покрыть 5 кейсов.
Правка кода по диффу:
Вот дифф кода. Обнови только изменённые участки и опиши, почему.
DIFF:
Пример: быстрый проект, который можно сделать бесплатно (пошагово)
Цель: CLI‑утилита, которая конвертирует CSV с лидами в нормализованный JSON и генерирует черновик письма.
- Бэкенд: Ollama + Llama 3.2 3B.
- Промпт: «Приведи таблицу к JSON‑схеме X. Затем создай письмо для сегмента Y с 3 вариантами тем.»
- Файлы: data.csv → normalized.json, draft_email.md.
- Валидация: прогоните 5 тестовых строк, проверьте поля и тон письма.
- Итог: готовый артефакт для маркетинга/пресейла.
Сводка: рекомендованные инструменты в зависимости от задачи
- Минимальный ноутбук, скорость важнее качества: TinyLlama или Phi‑3 Mini в Ollama.
- Баланс качества и скорости без GPU: Llama 3.2 3B в LM Studio или Ollama.
- Качество кода и reasoning: Mistral 7B локально с квантизацией; онлайн — Claude/OpenAI.
- Интеграция в редактор: VibeCoding с локальным Ollama/LM Studio.
Как считать расходы: пример расчёта стоимости продакшна и калькулятор (примеры и формулы)
Базовая формула (облако):
Cost (мес) = Пользователи × Запросов/пользователя × Токенов/запрос × Цена за 1K токенов / 1000
Пример 1: MVP‑бот, 100 пользователей/мес, 20 запросов, 800 токенов/запрос, цена 0,3 USD/1K токенов.
- Cost = 100 × 20 × 800 × 0,3 / 1000 = 480 USD/мес (~43 000 RUB при 90 RUB/USD).
Пример 2: 1 000 пользователей, 10 запросов, 500 токенов, 0,15 USD/1K.
- Cost = 1 000 × 10 × 500 × 0,15 / 1000 = 750 USD/мес (~67 500 RUB).
Таблица‑рычаги оптимизации:
| Рычаг | Эффект | Пример |
|---|---|---|
| Кэширование ответов | −30–60% токенов | Кэш по prompt+inputs |
| Сжатие контекста | −20–40% | Резюмирование истории диалога |
| Дешёвая модель | −30–80% | Переключение с «премиум» на «мини» |
| Частичный локальный инференс | −20–50% | RAG/препроцесс локально, генерация в облаке |
Для локального деплоя расходы — «железо» (капекс) + электроэнергия; экономите на переменных затратах, но берёте на себя uptime и мониторинг.
Безопасность, лицензии и приватность при локальных моделях
- Лицензии: многие open‑source модели (Llama 3.2, Mistral, Phi‑3, TinyLlama) разрешают коммерческое использование при соблюдении условий. Проверьте лицензию репозитория и ограничения по размеру компании/пользователей.
- Данные: локальный инференс повышает приватность — код и документы не покидают ваш ПК.
- Логи и аудит: храните логи запросов/ответов с маскированием PII. Для облака — проверьте, используются ли данные для обучения.
- Соответствие: учитывайте GDPR и местные требования к персональным данным.
Когда переходить на платный тариф и как оптимизировать расходы
Переходите на тариф, когда:
- упираетесь в ограничения пробного лимита;
- нужны SLA, повышенные RPS или длинный контекст;
- важны предсказуемость затрат и поддержка.
Оптимизация бюджета:
- смешанный стек: локальный предпроцессинг/эмбеддинги + облачная генерация;
- адаптация промптов под меньшие модели;
- мониторинг среднего токен‑фута и A/B‑тестирование провайдеров;
- отложенный деплой на премиум‑модель до подтверждения метрик.
Часто задаваемые вопросы (FAQ)
См. также ответы выше и краткие справки по запуску.
- Можно ли обойтись без платежей на старте и с какими ограничениями придётся смириться? Ответ: да, локально — без оплаты, но со скоростью/качеством на вашем железе; онлайн — с пробными лимитами и возможной верификацией карты.
- С каких бесплатных моделей и бэкендов лучше начинать — локально и в онлайне? Ответ: Llama 3.2 3B/8B, Mistral 7B, Phi‑3 Mini, TinyLlama; бэкенды — Ollama, LM Studio, HF Agent/Inference.
- Как быстро запустить Ollama, LM Studio и Hugging Face Agent? Какие требования к системе? Ответ: смотрите раздел quickstart выше с командами для macOS/Windows/Linux и требованиями RAM/CPU.
- Нужна ли банковская карта для пробного доступа в популярных сервисах (Ругент, OpenAI, Claude)? Ответ: зачастую нужна; региональные сервисы принимают рубль (RUB) и СБП; локальные бэкенды карты не требуют.
- Как прикинуть бюджет продакшна при реальном трафике? Ответ: считайте по формуле Cost = запросы × токены × цена/1K; см. таблицу примеров и рычаги оптимизации.
Шаблоны и ресурсы — ссылки на команды, скрипты и репозитории
По правилам этого блога мы не размещаем URL. Ниже — ориентиры, чтобы быстро найти нужное:
- VibeCoding (VS Code extension) — страница расширения в Visual Studio Marketplace.
- Ollama — официальный сайт и документация по моделям (mistral, llama3.2, phi‑3, tinyllama и др.).
- LM Studio — сайт приложения с каталогом моделей и локальным сервером.
- Hugging Face — документация по Inference API, HF Agent и transformers.
Чек‑лист 1‑page cheat‑sheet (создайте PDF из этого блока):
- Команды установки Ollama, запуск: brew install ollama; ollama run mistral.
- Шаги LM Studio: Download модель → Start Server → указать порт в VibeCoding.
- HF Inference: установить transformers/accelerate; настроить токен; выбрать модель.
- Проверка: curl /v1/models; локальная интеграция в VibeCoding; тестовый промпт.
Итог: бесплатный старт реален — сначала локально, затем масштабирование в облаке. Для РФ доступны RUB и СБП; учитывайте лицензии и безопасность при деплое.
Частые вопросы
- Можно ли обойтись без платежей на старте и с какими ограничениями придётся смириться?
- Да. Локально — бесплатно, но производительность зависит от вашего ПК. В облаке — пробные лимиты и возможная верификация карты; лимитируют токены и скорость.
- С каких бесплатных моделей и бэкендов лучше начинать — локально и в онлайне?
- Локально: Llama 3.2 3B/8B, Mistral 7B, Phi‑3 Mini, TinyLlama; бэкенды — Ollama, LM Studio, HF Agent/Inference. В облаке — OpenAI/Claude/региональные агрегаторы с пробным балансом.
- Как быстро запустить Ollama, LM Studio и Hugging Face и какие требования к системе?
- Смотрите quickstart ниже: команды установки для macOS/Windows/Linux, запуск локального API и ориентиры по RAM/CPU/GPU. Для 3–4B хватает 8–12 ГБ RAM, для 7B комфортнее 16 ГБ+ или GPU.
- Нужна ли банковская карта для пробного доступа в популярных сервисах (Ругент, OpenAI, Claude)?
- Часто — да. Региональные сервисы принимают RUB и СБП; у международных — USD и верификация. Локальные бэкенды карты не требуют.
- Как прикинуть бюджет продакшна при реальном трафике?
- Считайте по формуле: пользователи × запросы × токены × цена/1K / 1000. В статье есть примеры расчётов и рычаги оптимизации (кэш, сжатие контекста, более дешёвые модели, частичный оффлоад локально).