Приложение и Telegram‑бот за вечер: практический маршрут
Коротко
Показываю, как за вечер собрать приложение и Telegram‑бота — от BotFather до продакшен‑деплоя. Внутри: таблица инструментов (no‑code, n8n, Replit/Bolt, Cursor/Claude Code), готовые промпты, код на python‑telegram‑bot, пошаговый деплой на Railway/Render/Fly.io. Завершаем безопасностью и расчётом бюджета.
От идеи до рабочего MVP — за счёт диалога с ИИ и готовых блоков: вы описываете поведение словами, а инструмент генерирует код, сценарии и интеграции. Ниже — пошаговый маршрут: как собрать простое приложение и Telegram‑бота за вечер, какие инструменты выбрать, как протестировать и запустить 24/7 без суеты.
Коротко о вайбкодинге и когда он уместен
Вайбкодинг — это сборка продукта через промпты и правки «по месту», без глубокого погружения в разработку. Термин часто пишут как vibe coding. Ключевая идея: вы выступаете архитектором — формулируете требования, быстро проверяете гипотезы и задаёте границы. Так можно собрать простые приложения, чат‑ботов, интеграции и небольшие внутренние инструменты.
Подходит, когда:
- нужно быстрое MVP за часы или один день, без долгого ТЗ и найма команды;
- логика прозрачна: запрос → обработка → ответ, интеграции по API;
- важен короткий цикл итераций: сказали инструменту — сразу получили результат — тут же поправили.
Не подходит, если требуются высокая нагрузка, строгие SLO, сложная доменная логика, зрелые практики безопасности или сертификация. В этом случае делайте прототип вайбкодингом, а продакшен переносите на классическую разработку.
Почему начинать стоит с Telegram‑бота (цели и кейсы)
Telegram Bot API прост, аудитория уже в мессенджере, а порог публикации и обновлений минимален. Это делает бота отличной стартовой площадкой.
Цели:
- быстрые интерактивные MVP: лид‑бот, FAQ, напоминалки, интеграция с CRM;
- внутренние ассистенты: заметки, трекинг задач, оповещения.
Типовые кейсы:
- FAQ‑бот с базой ответов и кнопками;
- сбор заявок в командный чат c UTM‑метками;
- напоминания и расписание для обучения/онбординга;
- ассистент по внутренним документам компании (RAG по файлам).
Маршрут по шагам: от BotFather до первого ответа (1–5)
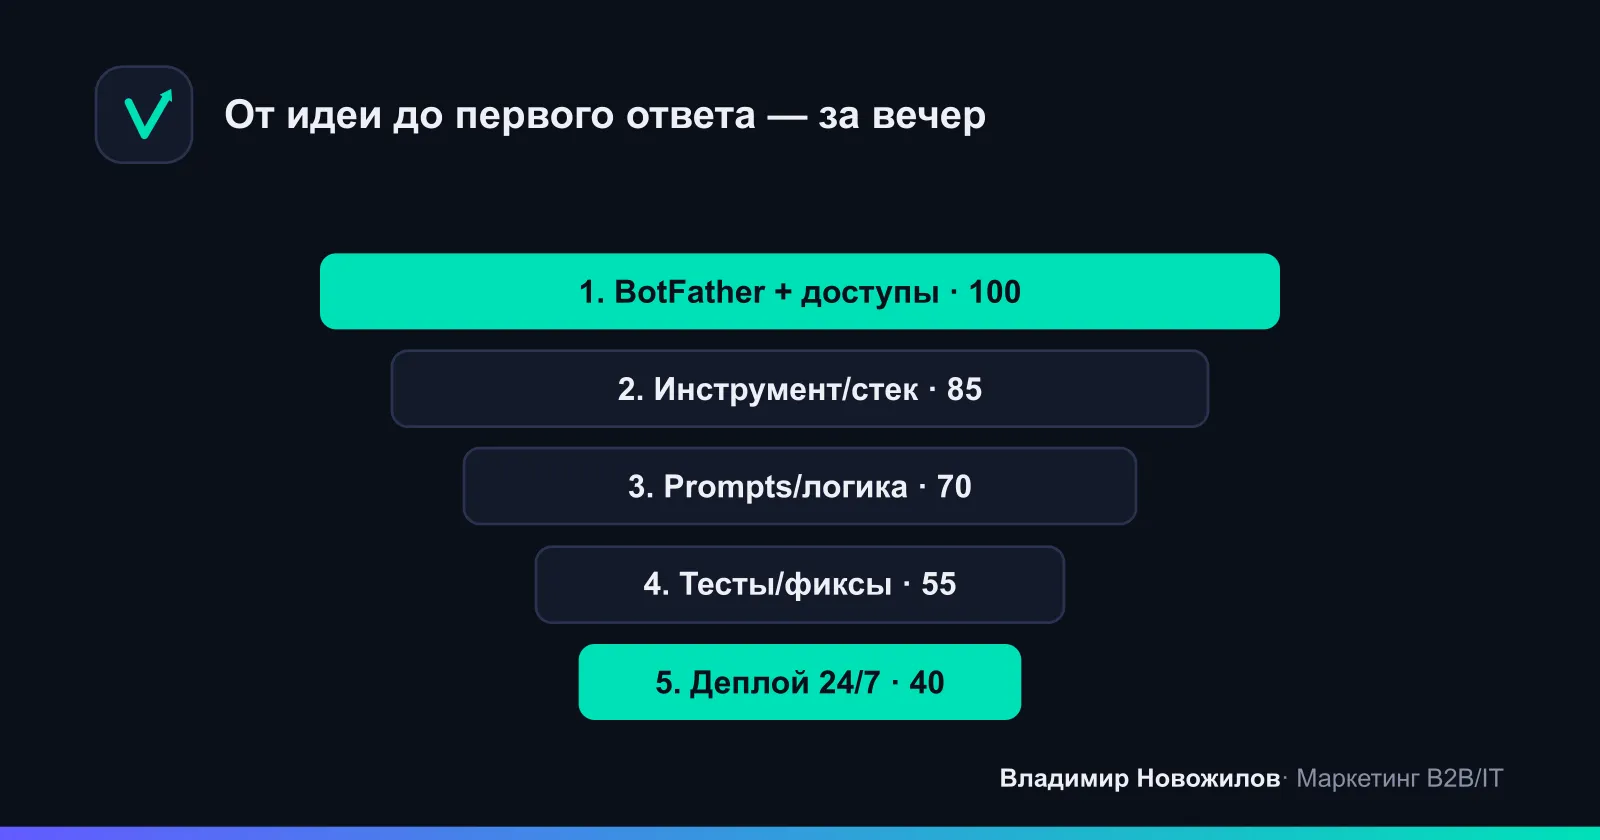
Этот план подходит и нетехам, и инженерам — он экономит часы и избавляет от лишних попыток:
- BotFather: создайте бота, получите токен. Продумайте имя и @username.
- Выбор инструмента: конструктор без кода, n8n, Replit/Bolt.new, Cursor или Claude Code.
- Промпты: опишите поведение, команду /start, формат ответов, ограничения.
- Локальный запуск и тесты: убедитесь, что бот отвечает и логирует ошибки.
- Деплой 24/7: выберите Railway/Render/Fly.io.
Чек‑лист «от 0 до рабочего бота»:
- токен от BotFather сохранён в .env и НЕ в git;
- LLM / API token оформлен; доступы ограничены;
- команды /start, /help, базовые сценарии работают;
- логирование ошибок включено, есть трассировка;
- деплой и автоперезапуск настроены, есть мониторинг uptime/latency.
Сравнение подходов и инструментов: no‑code, n8n, Replit, Bolt.new, Cursor, Claude Code
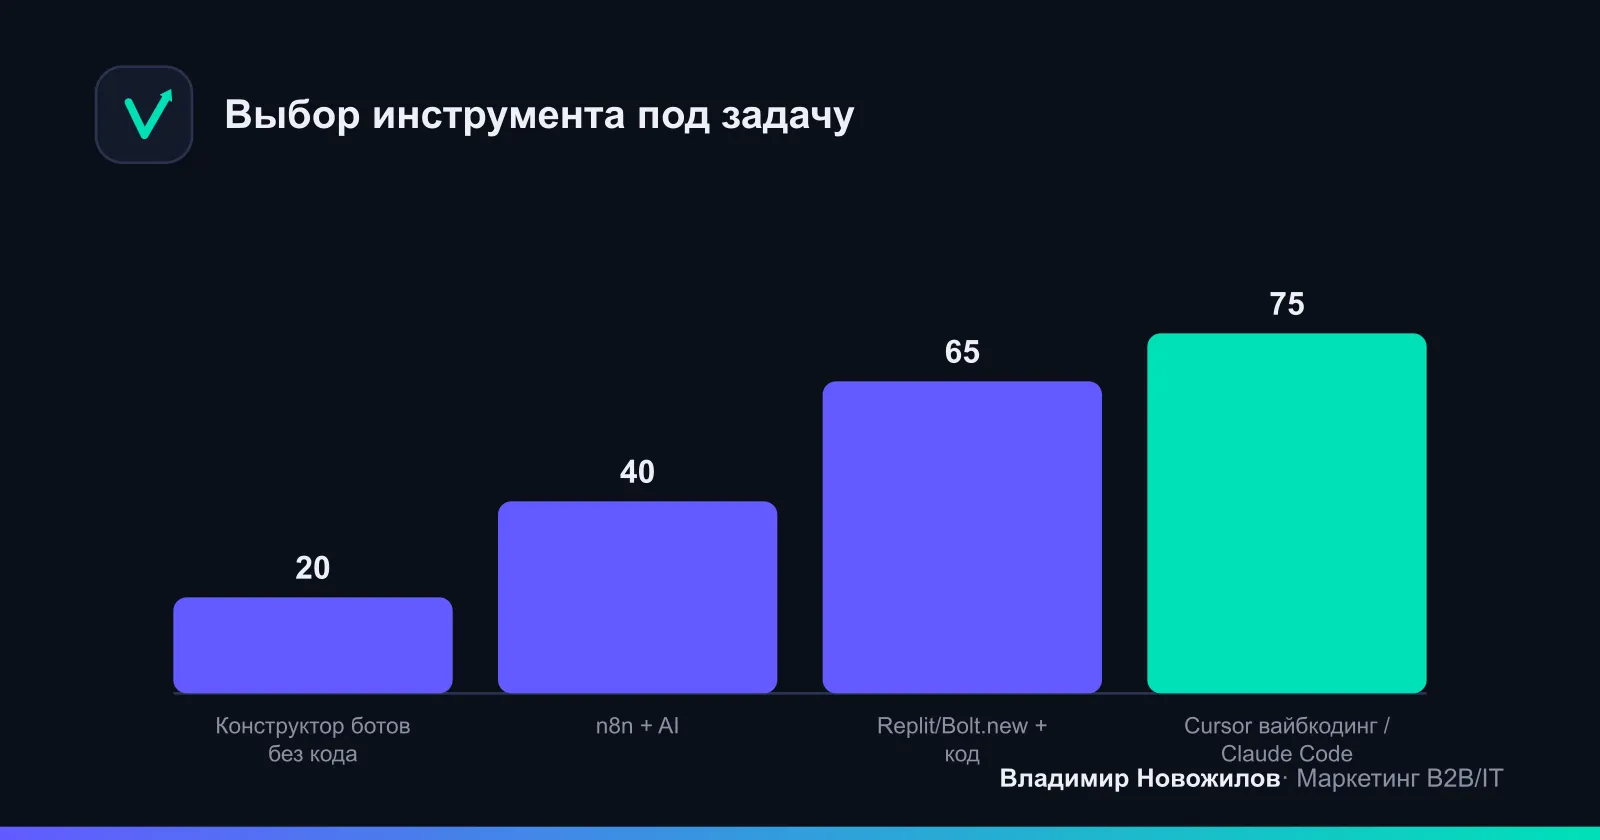
Ниже — короткий срез по стеку. Выбирайте инструмент под задачу и бюджет.
| Подход | Инструменты | Сложность | Цена (оценка) | Когда уместно | Плюсы | Минусы |
|---|---|---|---|---|---|---|
| No‑code конструктор | Конструктор ботов без кода | Низкая | 0–20$/мес | Простой FAQ/лиды | Быстрый старт | Ограниченная логика/интеграции |
| Воркфлоу‑оркестрация | n8n | Низкая‑средняя | 0–20$/мес (cloud/self-host) | Интеграции, триггеры | Много коннекторов | Сложнее отлаживать сложную логику |
| Онлайн IDE | Replit, Bolt.new | Средняя | 0–10$/мес + LLM | Свой код, гибкость | Код под контролем | Нужны базовые знания кода |
| AI IDE (vibe coding) | Cursor, Claude Code | Средняя‑высокая | 10–40$/мес + LLM | Генерация/правка кода | Быстрая генерация | Требует аккуратных промптов |
Примечания по РФ: доступ к отдельным платформам может потребовать VPN и зарубежную карту. Рассмотрите локальные LLM (Яндекс, GigaChat) и облака в местных дата‑центрах — это снижает задержки и упрощает соответствие 152‑ФЗ.
n8n + AI: пошаговый разбор (команды и схема)
В n8n логику собираем блоками: триггеры → обработка → ответ.
Шаги:
- Доступы: получите токен бота в BotFather и ключ LLM. Сохраните как ENV в n8n (Settings → Credentials / Variables).
- Триггер: добавьте Telegram Trigger (получение сообщений). Настройте polling.
- Обработка: добавьте узел AI (LLM) или Function для предобработки, например нормализуйте текст.
- Промпт: пропишите систему и формат. Пример системного промпта:
Ты — Telegram‑бот компании {{COMPANY}}. Отвечай кратко и вежливо. Язык — русский.
Если вопрос вне базы, предложи связаться с человеком (тег @{{OPERATOR}}).
Структура ответа: 1) краткий ответ; 2) кнопки (если уместно); 3) дисклеймер о точности.- Ответ: добавьте Telegram node «Send Message», передайте текст из LLM.
- Логирование/алерты: добавьте узел для записи в таблицу/Google Sheet/БД.
- Тест: запустите воркфлоу, проверьте команды /start, /help и 5–10 типовых вопросов.
Где добавить RAG: вставьте узлы для поиска по файлам/таблицам и передавайте найденный контекст в промпт LLM.
Replit/Bolt: проект и деплой по шагам
Подход для тех, кто хочет контролировать код и зависимости.
- Стек: Python 3.11+, библиотека python-telegram-bot (версия 22+, async). Создайте проект в Replit или Bolt.new.
- Файлы проекта:
requirements.txt
python-telegram-bot==22.3
python-dotenv==1.0.1
uvloop==0.19.0 ; platform_system != 'Windows'
.env (локально; на проде — ENV переменные)
TELEGRAM_TOKEN=123456:ABC...
ENV=dev
main.py
import asyncio
import logging
import os
from dotenv import load_dotenv
from telegram import Update
from telegram.ext import ApplicationBuilder, CommandHandler, MessageHandler, ContextTypes, filters

load_dotenv()
logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
TOKEN = os.getenv("TELEGRAM_TOKEN")

async def start(update: Update, context: ContextTypes.DEFAULT_TYPE):
    await update.message.reply_text("Привет! Я ваш MVP‑бот. Напишите вопрос или команду /help.")

async def help_cmd(update: Update, context: ContextTypes.DEFAULT_TYPE):
    await update.message.reply_text("Доступно: /start, /help. Просто задайте вопрос — отвечу шаблонно.")

async def echo(update: Update, context: ContextTypes.DEFAULT_TYPE):
    text = update.message.text or ""
    # TODO: здесь можно вставить вызов LLM или бизнес‑логику
    reply = f"Вы написали: {text}. Скоро здесь будет интеллект."
    await update.message.reply_text(reply)

async def main():
    application = ApplicationBuilder().token(TOKEN).build()
    application.add_handler(CommandHandler("start", start))
    application.add_handler(CommandHandler("help", help_cmd))
    application.add_handler(MessageHandler(filters.TEXT & ~filters.COMMAND, echo))
    await application.initialize()
    await application.start()
    await application.updater.start_polling()
    await application.updater.idle()

if __name__ == "__main__":
    try:
        asyncio.run(main())
    except (KeyboardInterrupt, SystemExit):
        logging.info("Shutting down...")
Локальный старт:
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python main.py
Советы:
- в Replit/Bolt.new храните TELEGRAM_TOKEN в «Secrets/ENV»;
- добавляйте LLM / API token для интеграций (например, вызов внешней модели);
- для крупных проектов используйте Cursor или Claude Code — они быстрее генерируют и правят код по промптам, поддерживают MCP (интеграционный протокол) для доступа к внешним инструментам и БД.
Готовые промпты и шаблоны для 5 типовых ботов
Ниже — готовые промпты. Вставляйте как системное сообщение или «инструкцию разработчику» в AI IDE.
- Бот‑FAQ службы поддержки
Роль: бот‑консультант компании {{COMPANY}}. Язык — русский.
База знаний: краткие статьи (Q→A). Если вопрос вне базы — отвечай «Нужна помощь оператора» и попроси оставить телефон.
Формат ответа: 1) кратко до 4 предложений; 2) список кнопок (2–4) с командами; 3) дисклеймер: «Ответ сгенерирован ИИ».
Ограничения: не давай финансовых/юридических рекомендаций; не собирай ПД без согласия.- Лид‑бот для заявок
Роль: бот для сбора лидов. Критерии лида: имя, телефон, интерес.
Сценарий: /start → приветствие → вопросы по одному. Проверка телефона — regexp. Результат — карточка лида (JSON) + подтверждение.
Обработка ошибок: если юзер уклоняется, повтори вопрос, предложи «Пропустить».- Ассистент команды (заметки/таски)
Роль: ассистент команды. Команды: /note, /list, /done.
Правила: хранить заметки по user_id, форматировать в списки. При /done — помечать завершенным.
Тон: лаконично, без воды. Время — московское.- Бот‑напоминалка
Роль: напоминания пользователю.
Сценарий: «Напомни завтра в 10:30 позвонить клиенту» → парсинг даты/времени → подтверждение → планировщик.
Если время в прошлом — попроси уточнить.- Внутренний бот‑поиск по документам (RAG)
Роль: ищи ответ по базе PDF/Google Docs, возвращай цитаты + ссылки на разделы.
Если уверенность < 0.6 — спроси уточнение.
Формат: 1) краткий ответ; 2) выдержки с источниками; 3) что спросить дальше.
Эти шаблоны можно вставлять как системные промпты в Cursor/Claude Code или использовать в узлах n8n.
Тестирование и отладка: сценарии и примеры ошибок
Минимальный набор тест‑кейсов:
- /start, /help всегда отвечают без ошибок;
- нестандартные вводы: смайлы, пустые сообщения, длинные тексты, вложения;
- 10 вопросов из FAQ; 10 — «за гранью» базы;
- имитация падений LLM/сетевых ошибок — бот отвечает запасной фразой;
- нагрузка: 20–50 последовательных сообщений за 1–2 минуты без деградации.
Что логировать:
- входные/выходные события, user_id (при необходимости хэшируйте);
- технические метрики: uptime, latency, cost per request, token usage;
- ошибки с трейсами, но без токенов и ПД.
Частые ошибки:
- токен в репозитории — закрывайте .env через .gitignore;
- зависание на одной сессии LLM — триммируйте контекст;
- бесконечные ретраи — ограничивайте попытки, ставьте таймауты.
Деплой 24/7: Railway, Render, Fly.io — инструкции и конфиги
Общий принцип: задаём окружение, описываем процесс, включаем автоперезапуск.
Railway (под polling):
- «New Project → Deploy from GitHub»;
- Variables: TELEGRAM_TOKEN, ENV=prod;
- Start Command: python main.py;
- Healthchecks включены. Для вебхуков понадобится публичный URL и SSL.
Render:
- «New +» → Web Service (для вебхуков) или Background Worker (для polling);
- Environment: Python; Start Command: python main.py;
- Переменные окружения в Settings.
Fly.io (Docker):
Dockerfile
FROM python:3.11-slim
WORKDIR /app
COPY requirements.txt ./
RUN pip install --no-cache-dir -r requirements.txt
COPY . .
CMD ["python", "main.py"]
Команды:
fly launch --now
fly deploy
fly logs
Procfile (если нужен для некоторых PaaS):
worker: python main.pyВебхуки vs polling:
- Polling проще для старта, не требует публичного HTTPS;
- Вебхуки экономят трафик и ускоряют отклик, но нужен публичный URL и корректная обработка 200 OK.
Безопасность и секреты: токены, ротация, логи, права
Чек‑лист безопасности:
- храните TELEGRAM_TOKEN и LLM/API‑ключи только как переменные окружения (.env локально, Secrets/ENV на PaaS);
- ревокация и ротация ключей раз в 30–90 дней;
- разные ключи для dev/stage/prod; ограничивайте скоупы доступа;
- gitignore для .env, логов, артефактов; не записывайте ПД в логи;
- уведомления об ошибках в отдельный канал/почту;
- соответствие 152‑ФЗ: хранение/обработка ПД и, при необходимости, локальный хостинг.
Про AI IDE:
- Cursor/Claude Code: храните секреты в их Secret Store или окружении проекта;
- MCP (интеграционный протокол) используйте для безопасного доступа к БД/файлам через прокси‑серверы.
Сколько это стоит: бюджет, тарифы LLM и пример unit‑economics
Статичная формула для оценки:
- Стоимость_хостинга = фикс/мес (PaaS‑план)
- Стоимость_LLM = N_сообщений × Средний_токенов × Цена_за_1к_токенов / 1000
- Итого = Хостинг + LLM + Запас 20–30%
Пример (оценка):
| Параметр | Значение |
|---|---|
| Сообщений в месяц | 5 000 |
| Средний токенов (prompt+completion) | 800 |
| Цена за 1k токенов | 0.002–0.01 USD |
| Стоимость LLM | 5 000 × 800/1000 × 0.002–0.01 = 8–40 USD |
| Хостинг (Railway/Render/Fly.io) | 5–10 USD |
| Итого (с запасом 25%) | 16–62 USD/мес |
Unit‑economics примера лид‑бота:
- Конверсия в лид: 6%; лидов/мес: 5 000 × 6% = 300;
- Cpl_бот = Итого/Лидов = 16–62 / 300 = 0.05–0.21 USD;
- Если средняя ценность лида > 0.21 USD — юнит‑экономика сходится.
Опции для РФ:
- локальные LLM (Яндекс, GigaChat) — проще с оплатой, ниже latency, тарифы сопоставимы;
- оплата зарубежных сервисов — через карты дружественных юрисдикций или платёжные платформы‑посредники; часть шагов может требовать VPN.
Частые ошибки и как их исправлять (чек‑лист)
- Спам в одном промпте. Лекарство: разнесите роли и инструкции по модулям.
- «Утекшие» токены. Лекарство: .gitignore + ротация + секреты только в ENV.
- Монотестирование. Лекарство: таблица тест‑кейсов и smoke‑тест перед релизом.
- Отсутствие метрик. Лекарство: логируйте uptime, latency, cost per request, token usage.
- Слепой выбор модели/инструмента. Лекарство: пилот на 2–3 вариантах, выбирайте по TCO.
Кейсы: три законченных проекта с исходниками
- Напоминалка для встреч (Python + python-telegram-bot)
- Функции: парсинг «Напомни завтра в 10:00», планировщик asyncio, список активных напоминаний.
- Фрагмент исходника планировщика:
from datetime import datetime, timedelta
from asyncio import create_task, sleep

reminders = {}

async def schedule(chat_id, text, when: datetime):
    delay = max((when - datetime.now()).total_seconds(), 0)
    async def job():
        await sleep(delay)
        await app.bot.send_message(chat_id, f"Напоминание: {text}")
    task = create_task(job())
reminders.setdefault(chat_id, []).append(task)- Бот‑FAQ с n8n и LLM
- Узлы: Telegram Trigger → Function (очистка текста) → LLM (шаблон из раздела prompts) → Send Message → Google Sheets (лог);
- Поведение: если уверенность < 0.6 — просим уточнение, иначе даём цитаты из базы.
- Мини‑приложение «Оценка запроса» через Bolt.new
- Цель: форма ввода текста → оценка тональности → ответ бота.
- Почему это «приложение»: отдельный веб‑эндпоинт + бот‑обвязка. Это показывает, что собрать приложение подобным способом реально за вечер.
Итоги
Быстрый путь к приложению и Telegram‑боту — это не «магический ИИ», а аккуратная архитектура: чёткий промпт, верно выбранный инструмент и дисциплина деплоя. Если важна скорость, начните с бота, проверьте гипотезы и процессы, затем масштабируйте в полноценное приложение. В гайде выше — шаги от BotFather до 24/7‑деплоя, таблица инструментов, готовые промпты, конфиги и рекомендации по безопасности и бюджету.
FAQ: короткие ответы на частые вопросы
Вопрос: Как быстро запустить Telegram-бота без кода? Ответ: Самый простой путь — конструктор ботов без кода или n8n: получаете токен в BotFather, собираете сценарий из блоков (триггер → обработка → ответ), добавляете LLM / API token и деплоите на Railway/Render/Fly.io. Для сложных сценариев используйте AI IDE (Cursor/Claude Code) — они генерируют и чинят код по промптам.
Вопрос: Можно ли этим подходом собрать не только бота, но и веб‑приложение? Ответ: Да. Через Replit/Bolt.new или AI IDE можно собрать простой веб‑сервис с API и страницей за 1–2 вечера. Сохраните модульную архитектуру, держите секреты в ENV и следуйте чек‑листам тестирования/безопасности.
Вопрос: С каких инструментов начать новичку? Ответ: Начните с конструктора для простых сценариев и n8n для интеграций. Затем переходите к Replit/Bolt.new, когда нужен контроль кода. Cursor и Claude Code пригодятся для генерации и рефакторинга кода, особенно вместе с MCP для подключения к БД и внешним сервисам.
Вопрос: Как быстро масштабировать бота по нагрузке? Ответ: Перейдите с polling на вебхуки, вынесите LLM‑вызовы в очередь/воркер, кэшируйте частые ответы, добавьте rate limit и горизонтальный скейлинг инстансов. Мониторьте latency и error rate, держите запас по CPU/RAM.
Вопрос: Что делать, если PaaS недоступен из РФ? Ответ: Используйте VPN и зарубежную карту, либо локальные облака с совместимыми стеками. Локальные LLM уменьшают задержку и риски платежей, но проверьте качество на своих кейсах перед продом.
Частые вопросы
- Как быстро запустить Telegram‑бота без кода?
- Самый простой путь — конструктор ботов без кода или n8n: берёте токен в BotFather, собираете сценарий из блоков (триггер → обработка → ответ), добавляете LLM/API‑ключ и деплоите на Railway/Render/Fly.io. Для более сложных сценариев переходите к AI IDE (Cursor/Claude Code): они генерируют и чинят код по промптам.
- Можно ли этим подходом собрать не только бота, но и веб‑приложение?
- Да. Через Replit/Bolt.new или AI IDE за 1–2 вечера реально поднять простой веб‑сервис с API и страницей. Держите архитектуру модульной, секреты — в ENV, следуйте чек‑листам тестирования и безопасности.
- С каких инструментов начать новичку?
- Для простых сценариев — конструктор; для интеграций — n8n. Нужен контроль кода — Replit/Bolt.new. Для генерации и рефакторинга кода подключайте Cursor или Claude Code (особенно в связке с MCP для безопасного доступа к БД и сервисам).
- Как масштабировать бота при росте нагрузки?
- Переключитесь с polling на вебхуки, вынесите LLM‑вызовы в очередь/воркер, кэшируйте частые ответы, добавьте rate‑limit и горизонтальный скейлинг. Следите за latency и error rate, держите запас по CPU/RAM.
- Что делать, если PaaS недоступен из РФ?
- Используйте VPN и зарубежную карту либо локальные облака со совместимым стеком. Локальные LLM снижают задержки и упрощают оплату, но обязательно проверьте качество на своих кейсах до продакшена.